📄 跨项目迁移的咨询质量评估:量表锚定的文本打分如何胜过域内训练
标签:#口语理解 | #领域适应 | #大语言模型 | #模型集成 | #教育
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
👥 作者与机构
- Tobias Hallmen:Chair for Human-Centered;Artificial Intelligence;University of Augsburg
- Elisabeth André:Chair for Human-Centered;Artificial Intelligence;University of Augsburg
📌 核心摘要
每个项目仅有53-85个专家评分会话,论文输入完整会话的双人转录文本与每人一路音视频,输出1-5分的受评者整体印象,难点是量表跨项目命名不一、目标集中在3-4分且录音与说话人归属带噪声。处理先把按时间排序的双人转录文本送入小型开放权重的大语言模型评委,输出会话级构念分,构念分指专家量表中某一可练习行为对应的会话级评分,再与紧凑非言语双人特征拼接,所有低维特征块按域做z校准后在两个域混合训练、第三个域测试。在Ticks蜱虫咨询57会话、Vacc疫苗咨询53会话、Teach家长教师咨询85会话共195会话上,嵌套留一域外评测下以Spearman等级相关为指标,混合训练达0.54,超过域内五折交叉验证的0.48以内。在相同195会话上配对比较留一域外与域内训练的会话级Spearman等级相关,留一域外评测下配对差距为+0.15,匹配训练量后在留一域外与域内比较中仍保留+0.12。在留一域外评测下以Spearman等级相关为指标,语言评委集成达0.51,叠加整个非言语块仅比语言评委集成增加约0.03且区间包含零。在固定模型与转录本的留一域外对照下以Spearman等级相关为指标,采用专家构念的评委由通用对话质量的0.32升至0.41,引用量表原文描述仅再增0.004。结论只适用于中等水平模拟咨询的排序,预测压缩到不足1个量表点,不支持直接报分,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么沟通质量自动评估缺数据
这篇论文研究双人模拟咨询会话的沟通质量自动评估。输入是每个会话的完整录音录像和双说话人转写,输出是对被评估者总体印象的 1 到 5 分预测,监督来自领域专家的整体打分。难点在于专家时间稀缺,每个培训项目只能积累几十个带评会话,而且不同项目的量表措辞和分级不同,直接在域内做监督学习会在小样本上很快碰到天花板。
论文用德国同一所大学的 3 个德语语料做载体:蜱虫叮咬全科咨询 57 场、婴儿疫苗犹豫咨询 53 场、家长教师咨询 85 场,共 195 场专家打分会话。两个医学语料用柏林总体评价的总体印象题,教师语料用对应的总体题,其中教师语料前 24 场用 5 分、之后改用 4 分并需要重新等值。理解这个背景才能明白后文为什么把跨域迁移作为主评估,而不是继续在单域内调参。
已有路线为什么停在单域相关分析
原文把相关工作分成 3 条线。第一条是模拟咨询评估本身,此前工作多是把专家分与人工标注的非言语参数、生理唤醒、微笑编码或自动提取的非言语特征做回归或反馈,都在单个项目内做,教师语料的阶段与技术编码器迁移到医学咨询时性能大幅下降。第二条是语言模型作打分者,此前多用于评价机器生成文本,或在心理治疗转写上预测行为编码,但都在同一域内且需要数百到上 1000 会话;课堂打分工作也是在同一量表内零样本打分。
第 3 条是跨语料泛化,在情感计算中已知跨录制条件和标注体系会大幅退化。本文的不同在于输入、目标和运行阶段都对齐到可比条件:输入都是双人咨询会话,目标都是专家总体印象,运行阶段都是在未见过的第 3 个项目上测试。论文认为迁移值得一试,是因为 3 个量表共享一套咨询质量构念体系,结构化、共情、会话技术在不同学科只是换了名字和测量方式。
要预测什么以及什么算成功
每个会话被压缩成一个会话级标量向量,再预测一个总体分。目标是被评估医学生或师范生的总体印象,医学域是柏林总体评价总体题反转后 5 分最好,教师域是对应的总体题。目标分布集中在 3 到 4 分,等级感强而绝对误差意义弱,因此主指标用 Spearman 等级相关,数值越高表示排序越接近专家,平均绝对误差只作完整性报告。评估分两种:留一域迁移是在两个混合外域上训练、在第 3 个域上测试,取三折平均;域内对照是在目标域内做五折交叉验证。
论文还区分嵌套选择与固定配置两种选择协议,前者在内层留一训练域上选集成成员,后者对所有特征集用同一套主成分加弹性网,两种结果相差 0.01,说明不是靠搜索配置刷出来的。
专家总体印象 × 留一域迁移: 专家总体印象指每个会话对被评估者沟通质量的 1 到 5 分整体打分,是唯一监督目标;留一域迁移指用两个域的混合数据训练、在第三个完全未参与训练的域上测试。两者搭配模拟新培训项目上线时没有本项目标注的部署条件,比较的是跨项目学到的通用映射,而不是同一批评分者风格的拟合。
整体流程如何从转写和录像走到跨域预测
读这张流程图时,先抓住两条输入分支,再看它们在哪里汇合为跨域回归。左侧 3 个语料进入后,一路是双说话人转写,带时序和 B 与 G 的中性角色标签,不带医生或教师等职业先验,送给多个语言模型打分者输出 1 到 5 分的构念分;另一路是按说话人采集的音频视频,提取韵律、面部与语音情感、注视微笑、轮换与双人差值等特征。所有低维块只对特征做按域 z 校准,不碰标签,含义是把不同项目中打分 3 所处的好坏位置拉齐,但需要一批无标签的目标域会话来估计均值方差,因此是直推式的。然后模型在两个混合外域上拟合,用主成分投影加弹性网,预测留出域的专家分。
看图路径: 1. 先沿左侧三语料到双说话人转写的主路径看两条分支;2. 再看顶部专家量表以锚定方式进入文本打分分支的位置;3. 最后看按域校准与两域混合训练到留出域预测的箭头顺序
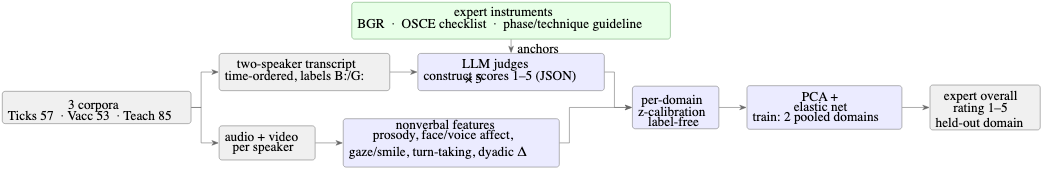
论文图 1。原论文 Figure 1::“Pipeline. Both speakers’ transcripts feed LLM judges whose constructs are largely derived from the expert rating instruments; nonverbal-dyadic features come from the recordings.”。
流程图实际显示转写分支在上、音视频分支在下,顶部绿色框的专家量表以锚定方式进入文本打分,中间经按域校准汇到同一回归器,最右输出留出域的 1 到 5 分专家总体分。这张图没有给出具体超参数,只交代信息流向:标签只在源域训练时出现,目标域只贡献特征分布。
文本打分者问了什么以及怎么运行
核心特征是小规模本地开放权重模型通读整场双人转写后给出的会话级构念分,以 JSON 返回。转写截断上限为 16k 字符,实际最长转写 15.2k 字符,没有会话真正触发截断;生成预算也没有撞墙,思考模式在最长的七场上只生成 455 到 780 个 token。构念分 3 组:通用对话问共情、结构、清晰、回应、投入,跑在 gemma3-12B 和思考模式的 qwen3-14B 上以获得去相关误差;柏林评价加共情技术清单问镜像、NURSE、积极倾听、连贯性、柏林共情、言语表达、总成绩和对方满意度,跨模型家族运行。
阶段加技术问开场框架、阶段完整性、决策具体性、结尾质量、情感化、复述、结构化。每个运行覆盖全部 195 会话。
生成用模型卡推荐的采样参数并固定种子,解析失败最多按种子递增重试 2 次。候选模型先过无标签筛选门:在 30 场试点上 90% 以上三试内可解析且构念间平均标准差不低于 0.35,只筛掉天花板坍缩,不看与目标的一致性。4 个负结果是 gemma4-12B 和 granite4.1-8B 塌到量表顶端,两种推理模式频繁破坏 JSON 契约。存活的打分依然保守,多数构念挤在 3 到 4 带,两个构念几乎是常数,靠方差阈值丢掉死列,再靠按域校准恢复区分信号。
量表锚定打分 × 通用对话打分: 量表锚定打分指把柏林总体评价、共情技术清单、咨询阶段与技术手册中的构念和分级描述改写进提示词,让模型按 1 到 5 分输出会话级构念分;通用对话打分指只问共情、结构、清晰等泛化维度。前者决定问什么行为,后者作为对照,组合后说明提升来自选对了构念,而不是用了更大的模型。
非言语双人块与表面统计在比什么
这一节把容易混淆的两组基线分开。非言语双人块名义上是非言语,但轮换计时来自转写时间戳,差值里还含语速和转写情感,因此是双人交互块而不是纯声视块;附录还报告了去掉所有转写衍生列后剩 26 个纯声视特征的版本,反而在固定配置下更好,说明转写衍生列曾稀释该块。浅层文本统计是另一条对照,7 个经时长归一化的表面量,用来检验差距到底来自语言理解还是多说话。句子嵌入和韵律同步是更强的反例:四代嵌入器跨域最差,韵律同步加入任何组合都稀释性能。这些对照的共同条件是同一留一域划分、同一 Spearman 指标和同一聚合方式,因此可以直接比较模态归因。
非言语双人块 × 浅层文本统计: 非言语双人块指韵律、面部表情、注视微笑、轮换时延、双人情感差值和韵律同步等会话级标量,强调被评估者减去对话伙伴的差值和共同注视等交互量;浅层文本统计指每分钟话语数、平均词长、提问比例等不涉及语义理解的表面量。两者共同作为基线,用来检验语言理解相对表面话量和非言语通道到底多了多少可迁移信号。
没有训练大模型时实际拟合了什么
本研究没有微调任何语言模型或特征提取器,所有推理都在本地完成。实际需要拟合的是最后的回归管线:中值填补加方差阈值加标准化加选择器加回归器。填补处理的是可解释缺失,不是随机缺失,包括缺单人流的语料、无单人声学的切分音频,以及一场面罩损坏导致面部特征全坏但检测置信度仍高的会话。选择器比较单变量 F 值、互信息、递归消除和主成分,回归器比较岭回归、弹性网、径向基支持向量回归、梯度提升和全阈值有序回归。
主结果用主成分 10 维加弹性网,附录证明从 3 到 50 维结果稳定在 0.551 附近,2 维为 0.552,因此 10 不是调出来的最优点,而是平台宽度内的任意取值。集成成员的选择在内层留一训练域上做,留出域不参与;特征集、选择器和回归器没有这样嵌套,但全嵌套重跑仍得 0.542,与 headline 只差 0.01。
按域 z 校准 × 主成分投影: 按域 z 校准指对打分和紧凑特征按每个域各自的均值方差做标准化,只用特征边缘分布、不用目标标签,用于去掉量表和语域偏移;主成分投影指把高度相关的打分向量降到少数正交方向再做弹性网回归。两者搭配是因为打分之间互相关很强,直接筛选会丢掉互补信息,而投影保留组合,再由带稀疏惩罚的线性头去噪。
数据划分与目标等值如何保证可比
3 个域的会话数、时长和评分者设计都不同。蜱虫 57 场约 7.1 分钟,1 名专家评全部加第 2 名评 15% 子集,一致性 0.80;疫苗 53 场约 6.9 分钟,4 名专家分片各评 17 到 18 场,双评子集一致性 0.77 到 0.85;教师 85 场约 9.5 分钟,4 名专家每场 1 人评目标分,另在 24 场子集上 4 人全评平行题,单评分者组内相关 0.53、平均后 0.82。目标都是有效单评分者读数,且专家两两精确一致仅 0.42 到 0.47,这是后文用信度开方估计上限的依据。
教师域的四分时代按等距重铺到 5 分区间,依据是任何编码在域内单调因而域内排序不变,可作无编码参照;等距编码与该参照只差 0.02,而直接下移编码虚高到 0.58 属于制造分离。疫苗域丢失单人音频,标签来自混合通道切分,后文用人工语音活动标注修复。交叉验证折没有按被试、演员或评分者分组,每场被评估学生互不相同,但蜱虫域只有一个标准化病人,演员与评分者会跨折重现,这是局限而非可比性缺陷。
跨域为什么能超过域内以及语言占多少
先看这张打分分布图,它解释了后文校准的必要性。纵轴是各构念,横轴是 1 到 5 分,颜色深浅表示落在该分的会话比例。可见绝大多数行集中在 3 到 4 两列,只有少数行在 1 或 5 端有拖尾;通用电池在 2 个模型上各出现 1 次,跨家族的柏林加清单运行被省略。教学信息是压缩不等于无信号,按域标准化后带内差异仍可用于排序。
看图路径: 1. 先按右侧分组标签区分通用、思考模式、清单与阶段技术四组;2. 再看横轴 1 到 5 分上颜色集中在 3 到 4 带的压缩现象;3. 对比不同行在高分端的拖尾差异,判断哪些构念还有区分度

论文图 2。原论文 Figure 2::“Score distributions over the 195 sessions.”。
分布图之后看主数字,下面这张表比较同一留一域平均下语言打分、堆叠与非言语基线的排序能力,指标都是 Spearman,越高表示与专家排序越一致。固定配置与每特征集最优配置两列并列,用来说明结论不依赖调参;域内列是五折对照。
| 特征集 | LODO 固定 | LODO 最优 | 域内最优 | 比较含义 | 适用条件 |
|---|---|---|---|---|---|
| 最终五打分集成 | 0.528 | 0.528 | 0.453 | 语言单独最强 | 三折平均 |
| 初始四打分集成 | 0.450 | 0.465 | 0.416 | 修复与跨家族前 | 同上 |
| granite 单打分 | 0.448 | 0.464 | 0.405 | 最强单打分 | 同上 |
| 最终加紧凑差值韵律 | 0.551 | 0.553 | 0.465 | 堆叠上限 | 同上 |
| 非言语双人块 | 0.008 | 0.281 | 0.173 | 非言语单独 | 最优格 |
| 句子嵌入 | 0.052 | 0.163 | 0.176 | 文本基线反例 | 同上 |
跨域迁移嵌套选择达 0.54,固定配置达 0.55,三折为 0.56、0.50 和 0.57;域内最强格在单次划分上 0.48,在 20 次划分重评后降到 0.47。在相同会话上配对比较,堆叠差距为 0.15,语言单独为 0.07,且每次自助重采样都为正。把外域训练集下采样到与域内训练同等大小,堆叠只掉 0.03 到 0.521,语言单独只掉 0.01,96% 到 100% 的抽样仍赢域内,因此不是数据量效应。非言语双人块单独最优格 0.281,叠加只加 0.029 且区间含零。
宽泛函数、嵌入和单通道非言语都停在 0.26 以下,浅层文本统计 0.26,因此差距来自语言理解而非话量。局限是三折估计波动大,域内单次划分曾偏悲观。
量表锚定与集成到底带来多少可运行的提升
这张表回答实际可运行策略之间的差距,而不是事后最优。比较条件是同一模型、同一转写和同一留一域划分,指标方向都是越高排序越准。第一行通用五构念为 0.321,第二行换成专家八构念但去掉分级描述升到 0.414,第三行加回引用分级只到 0.418,增量 0.004 落在单次运行的种子噪声内。
| 条件 | 指标 | 通用基线 | 专家构念裸版 | 加引用分级 | 比较对象 |
|---|---|---|---|---|---|
| 同模型同转写留一域 | LODO Spearman | 0.321 | 0.414 | 0.418 | 专家八构念相对通用五构念 |
| 同上分三折 | Ticks Vacc Teach | 0.34/0.32/0.30 | 0.45/0.36/0.43 | 0.40/0.43/0.42 | 跨域稳定性 |
| 语言单独集成演进 | LODO Spearman | 0.450 | 0.528 | 0.513 | 四打分相对五打分嵌套集成 |
| 叠加非言语对照 | LODO Spearman | 0.465 | 0.551 | 0.542 | 紧凑块相对完整双人块 |
分折看通用为 0.34、0.32 和 0.30,裸构念为 0.45、0.36 和 0.43,说明提升主要来自问对了什么,而不是把量表原文背下来,实践含义是三分之二的提示词字符可删而无损。集成侧 4 个初始打分集成 0.450,最终五打分集成 0.528,最强单打分 granite4.1-30B 单独 0.464,已接近整个初始四打分集成;qwen3.6 单打分跨种子只复现 44% 到 56%,做 3 种子均值后从 0.26 升到 0.38;phi4 因带压缩且单独 0.351,在内层三折全被拒绝,加入反而降 0.017。阶段加技术打分单独最优格 0.389,但与柏林加清单并列时只加 0.01,与两者构念重叠一致。
0.321 到 0.414 的对照还同时改变了构念数、提示长度和有无总分题,只有 0.414 到 0.418 是干净的锚定对照。跨家族运行用了改写后的抗带宽措辞而 gemma 原电池用旧措辞,因此家族效应与措辞效应在最终集成内无法分离。直接问量表总体题原文单独只有 0.26 到 0.28,不如锚定后的总分构念 0.35,句子嵌入四代都不超过 0.23,这些都是在 195 场总样本和三折估计下成立,换语言或换评分文化未经检验。
录制故障与量表改版各自值多少
先看模态归因条形图,它把可运行的堆叠、纯文本打分和非言语基线放在同一 Spearman 尺度下。最上方最终堆叠 0.55、最终打分 0.53,往下依次是初始堆叠、初始打分、单个强打分和各电池,最下方是转写统计、轮换、宽泛函数、句子嵌入、语音情感和韵律同步。颜色区分 3 组,条长直接可比,教学要点是所有红色非言语与表面基线都低于最弱的量表锚定打分,而蓝色堆叠相对绿色纯文本只长出一小截。
看图路径: 1. 先按图例颜色区分堆叠、纯文本打分与非言语基线三组;2. 再从上往下读最终堆叠到单个通用打分的递减顺序;3. 注意最下方韵律同步与句子嵌入条形的相对位置

论文图 3。原论文 Figure 3::“Modality attribution under LODO transfer: the language-based judges dominate; every nonverbal family, and the surface transcript statistics grouped with them, stays below the…”。
图后进入两个数据修复的定价,下面这张表把两种修复的误差规模、方式与效果放在同一 Spearman 尺度下比较,前者看本折与三折平均的提升,后者看上限与本折的恢复程度。
| 修复对象 | 误差规模 | 修复方式 | 本折变化 | 三折均值变化 | 备注 |
|---|---|---|---|---|---|
| 重叠轮换声学 | 恒为零 | 无法事后分离 | 0 | 0 | 嗓音仍来自混合通道 |
| 建模反转 | 5 级相对 7 级 | 解圆整后比较 | 有序模型失去优势 | — | 粗网格易虚高 |
疫苗域丢失单人音频后,16.1% 的切分段被标错说话人,修复后该折升 0.07,留一域均值升 0.05;最强构念上总成绩加 0.08、对方满意度加 0.11。代价是重叠类轮换特征恒为零、嗓音特征仍来自混合通道,无法事后分离双声。教师域四分时代的取整把 33.2% 的跨期会话对打成目标并列,把该折上限压到 0.93。等距解圆整后上限回到 0.97,该折从 0.51 升到 0.59,其中约 0.07 是被取整毁掉的排序信息,只有约 0.01 依赖等距假设。
说话人修复只修转写衍生特征,不修声学;等距选择依赖域内排序不变的参照和 4 人平行题均值的旁证,不是直接验证。粗粒度还会制造建模结论反转:在圆整目标上全阈值有序模型因只输出 5 个存储等级而赢过连续回归,在解圆整后失去优势。两者都只在当前样本量和当前切分质量下成立。
说话人归属修复 × 四分量表解圆整: 说话人归属修复指对丢失单人音频的疫苗咨询域,用人工语音活动标注把混合通道切分结果重新判给医生或家长角色;四分量表解圆整指把教师域四分时代存储时造成的取整碰撞重新拉开。两者都是数据完整性处理,前者恢复谁说了什么,后者恢复跨期可比的排序分辨率,组合后说明录制与编码选择会直接改变可测的迁移值。
哪些选择不影响结论以及上限怎么读
这张表把留一域、等量下采样留一域、等量域内对照放在同一固定配置下,便于区分来源与数据量。比较条件是同一主成分 10 维加弹性网、同一留出会话、域内参照平均过 20 次随机划分。
| 折 | 训练量 | 留一域 | 等量留一域 | 等量域内 | 超域内比例 |
|---|---|---|---|---|---|
| Ticks | 46 | 0.562 | 0.529 | 0.384 | 0.99 |
| Vacc | 42 | 0.483 | 0.442 | 0.306 | 0.98 |
| Teach | 68 | 0.607 | 0.592 | 0.527 | 0.98 |
| 堆叠均值 | — | 0.551 | 0.521 | 0.405 | — |
| 语言单独均值 | — | 0.528 | 0.520 | 0.460 | 0.96-1.00 |
去掉数据量优势后仍剩 0.12 和 0.06 的差距,96% 到 100% 抽样高于域内。域内单次划分曾偏悲观,尤其疫苗域在 0.293 到 0.417 之间波动,因此语言单独差距从 0.10 修正到约 0.07。全嵌套重跑三折选出 3 套不同管线仍得 0.542,说明配置不是结论来源。0.54 要对照人类一致性读:教师单评分者组内相关 0.53 开方约 0.73,医学双评 0.77 到 0.85 开方约 0.88 到 0.92,因此 0.54 约为最噪目标允许值的 75%、最干净的 60%。但该读法只是指示性而非严格上限,标注难的任务上模型可超人类一致,且主观构念分歧更宜看作真实变异而非噪声。
更有信息的是与在场人比较,单零样本打分与专家 0.32、0.29 和 0.41,标准化病人 0.33 和 0.47,学生自评 0.31 和 0.29,四专家均值 0.57,训练后模型 0.54 靠组合多份平庸判断超过非专家。误差上预测均值随真值单调上升但全程只跨 0.9 个 5 分点,标准差 0.43 对目标 0.99,2 次加权 kappa pooled 0.364,说明恢复的是排序而非刻度;极端会话的排序误差并不更大,模型只是不愿离开中心,这是集中目标下正则模型的预期行为。
结论在什么范围内成立以及什么还没分清
适用范围先说清。全部是德语模拟角色扮演,同一所大学不同学科,共 195 场三折估计,逐折 0.50 到 0.57 波动;目标有效单评分且集中中段,可学性与可测性都被压低;会话质量从平庸到很好,非言语极差的会话本来就拿不到高分,因此语言赢是该区间和该样本量下的比例陈述,不是非言语无用。分组上折没有按演员或评分者分组,每场学生互不相同但蜱虫域只有一个标准化病人,疫苗与教师评分者分片评分,无法分离学到的是咨询质量还是特定演员风格与评分者严厉度。
校准是直推式的,需要一批无标签目标会话估计特征均值方差,不支持单会话 intake 即到即评。输出只支持排序,条件均值跨度不足 1 分,报分数需重校准。打分者用德语提示,带有预训练中与德语文本相连的好咨询概念,未在其他语言与评分文化检验;除 3 种子均值的 qwen 外多为近确定性,但措辞敏感,同族 gemma4 会塌到顶端。提取器可能静默失败,面罩一场即例证,置信度不报警,需逐会话校验。非言语结论只对当前中等规模提取器成立,更强视觉骨干可能改变比例。
复现第一步做什么以及成本与资源现状
复现从转写与角色标签做起:用 WhisperX 类管线得到带时序的双说话人转写,统一为 B 被评估与 G 对话伙伴的中性标签并截断到 16k 字符,再跑 5 个最终打分、按域只对特征做 z 校准,最后用主成分加弹性网在两域混合上训练。随机部分要固定交叉验证折、互信息估计、梯度提升和主成分随机求解器,宽块曾因未固定种子在 107 个投影格上平均漂 0.01、最大 0.10。每次自助用按域分层 10000 次重采样同时评两系统。
成本上语言模型打分约 40 GPU 小时,12B 到 30B 模型经 4 比特量化在两台各一块 24 GB 显卡的工作站上完成,回归扫参纯 CPU 数小时。资源方面,本次没有发现来源绑定且完成可达验证的公开链接,因此不能声称代码、模型或数据已公开;论文称分析代码拟在接收后发布,录音及其会话级衍生因知情同意不发布,所有推理在机构内本地完成,涉及的开放权重与特征提取各按自带研究许可使用,生成式助手只用于编码与文字起草,不生成标签与结果。
什么时候值得尝试以及还缺哪项验证
当新项目只有五六十场带评会话、且量表与已有项目共享结构化、共情与技术这套构念时,值得尝试先混合外域数据加量表锚定打分做排序,而不是只在小样本内调参;若本项目已有批量无标签会话,可做按域特征校准,若只有单会话则当前管线不适用。复现第一步是把自家转写按 B 与 G 重标并跑通 5 个打分的 JSON 契约与方差门,再验证排序而非绝对分。
还缺的验证是逐题有效性与教学效果:当前只验证聚合排序,打分者构念逐题是否等价于训练有素评分者的题项未经域内一致性研究;反馈是否帮助学习者需要长期对照试验,以及跨性别、口音与语域的差异有效性尚未估计,因此分数只能用于形成性反馈并配人工复核,不能用于高风险决策。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses