📄 语音质量预测器有多容易被刷分:修正测量口径、横向比较与打补丁的效果
标签:#语音质量评估 | #语音增强 | #对抗训练 | #强化学习 | #基准测试
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Ali Alavi:机构信息未在 arXiv HTML 中可靠披露
- Donald S. Williamson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音质量预测器既做评测工具又做生成模型的奖励,优化它可能抬高分数而不改善听感,本文研究如何度量这种可攻击性以及修补是否有效。方法分三步:用强化学习策略在冻结神经编解码器隐空间加固定大小扰动;用无标签检测器同时检查分数是否超过编解码往返输出并检查独立客观面板是否变差;把命中的样本组成偏好对,用回归加排序损失微调预测器并重复多轮。相对已有攻击,关键差异是把是否算攻击的参照从原始输入改为零扰动往返输出,并报告多个独立训练攻击者中的最差情况。在500条BVCC测试语音、同一扰动强度下,以攻击成功率衡量,NISQA为89.6%,高于UTMOS22的5.7%,奖励选择本身就是鲁棒性决策。在BVCC训练的SSL-MOS及12个域外集上,以平均系统等级相关系数衡量,相对未防御的0.731,单空间三轮修补后降至0.637,多空间版本降至0.552,域外一致性代价明显。上述修补结论仅在EnCodec隐空间内成立,换到未见DAC攻击与白盒波形PGD时不再保持且随机扰动基线相当,修补研究使用3个随机种子共耗费46 A100-hours。攻击样本客观失真较小且未做听音实验,检测面板含神经指标且跨攻击族参照不一致,故结论限于黑盒温和隐空间攻击族和所用检测面板,未验证强攻击与人耳感知层面。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决什么实际任务
输入是一段待评价的语音波形,目标是输出一个尽量接近人打分的平均意见分(mean-opinion-score,简称 MOS)。这类平均意见分预测器(MOS predictor)现在有两个用途,一是做评价工具,给语音增强、合成和转换系统打分排序,二是做奖励,直接参与强化学习后训练,告诉生成模型往哪个方向改。必须保留的信息是真实听感的好坏,输出只是一个标量分数。论文要解决的具体问题是,挑选奖励模型时没有可比的依据:大家按和人评分的相关性、按先例或按工具包默认去选,但相关性高不等于难刷分。一个只加了微小扰动、听感没有变好的信号,如果能让分数涨很多,优化器就会去找这种捷径,这就是奖励劫持。
平均意见分预测器 × 奖励劫持: 平均意见分预测器指把一段语音波形映射为一个模拟人打分的标量模型,本文记为 R;奖励劫持指用该分数做奖励去训练增强或生成模型时,分数上升但真实听感没有变好甚至变差,本文把可刷分性单独拿出来测量,而不是只看预测器和人的相关性。
已有攻击和防御各在什么条件下比较
论文回顾了 3 类不同条件的已有工作,不能直接比胜负。第一类是直接攻击质量预测器,有的工作在波形上加峰值约束去逼近固定目标分,有的工作在训练数据里投毒一小段静音缺失,还有的工作完全不加范数约束,只报告 PESQ 和预测分的折中,攻击强度、成功标准和样本量都不一样。
第二类是单次加固,有的工作对波形扰动做 1 次对抗训练,有的工作在文本转语音奖励上做一轮更新,还有图像质量模型用梯度范数正则,但都没有攻击检测器,也没有下游生成器验证。第 3 类是闭环思路,和大语言模型奖励模型的 Adv-RM 做法相近,交替更新策略和奖励模型或做集成,但模态不同,论文明确说无法跨模态直接跑该基线。本文的差别是先统一测量口径和扰动大小,再把常用预测器放在同一攻击者面前比较,然后才审计闭环补丁。
为什么常用测量会把编解码器的影响算到攻击头上
论文指出的第一个测量偏差来自处理链。攻击并不是直接改波形,而是先经过一个冻结的神经编解码器,扰动加在隐变量上再解码。即使扰动为零,只过一遍编码再解码,预测器的打分也会变化。原文报告这个偏移在不同预测器上是负 0.10 到正 0.14 MOS,在不同防御版本上甚至可达正 0.95。如果判定规则拿原始输入的分数做基准,这部分编解码器自身的漂移会被记成攻击带来的加分。
修正办法是把基准换成零扰动往返输出的分数,只问扰动相对往返输出涨了多少分。论文用存储输出做了事后重算,发现仅换基准就能让 1 次防御的测量值变化约 4 倍,也能让多空间防御从看似崩溃变成相对稳健。第二个偏差是只训练一个攻击者。攻击者本身是用强化学习训练出来的,换个随机种子就可能完全不同,原文固定一个预测器时 5 个种子给出的成功率可以从 0.00 跨到 0.38,因此 1 次防御效果必须报告多个攻击者中的最坏情况。
攻击检测打补丁闭环的整体流程是什么
整个闭环按图 1 理解最清楚,先看主路径再看反馈回路。干净语音 x 先进入冻结的编解码器编码器得到隐变量 z,一个分组强化学习策略在隐变量上提出扰动,缩放到固定大小后再解码得到被攻击输出 y。预测器对 y 打分,这个分数既是攻击者训练时的奖励,也是后面判定是否刷分的依据。判定框要求同时满足分数上涨和独立指标变差,满足的样本构成偏好对去微调预测器,下一轮重新训练攻击者来打新版预测器。论文实际运行时上限规则曾用原始输入做基准,但所有报告数字都已按往返输出重算,理解时要以重算后的口径为准。
读图 1 时请按从左到右的主信号链看,再看从预测器回到策略和回到补丁的两条回路,注意虚线奖励和实线偏好对的区别。
看图路径: 1. 先沿左侧干净语音到编解码器编码器、策略加扰动、解码器输出的主箭头看一遍;2. 再看下方预测器打分回到策略的奖励虚线,以及右侧是否刷分的判定框;3. 最后看判定为刷分后如何构成偏好对并回到预测器做补丁
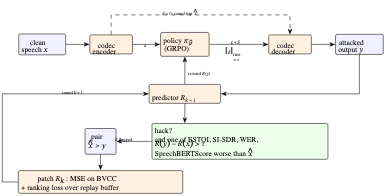
论文图 1。原论文 Fig. 1::“The attack–detect–patch loop. A GRPO policy perturbs codec latents at a fixed size; an output is flagged only if its score rises above that of the zero-perturbation round trip x…”。
图 1 显示左侧干净语音进入编解码器编码器,中间策略输出扰动并送入解码器得到被攻击输出,预测器同时接收往返输出和被攻击输出的打分比较,判定为刷分后把偏好对送入下方补丁模块,补丁在 BVCC 数据上的均方误差损失之外再加回放缓存上的排序损失,箭头回到预测器表示进入下一轮。这种画法把攻击空间固定、检测无须人工标注、补丁只改预测器这三点分工表达得很直接。
攻击者如何提出固定大小的隐变量扰动
攻击空间是连续的 EnCodec 24 kHz 隐变量,每秒 75 帧、128 通道。策略是一个 4 层 1 维卷积网络,输出每通道均值并配一个可学习的每通道标准差,从高斯分布中采样动作。关键设计是动作不随时间变化,即每句话只学一个通道维度的整体偏移,这样策略梯度方差才可控,原文说帧级动作在试过的尺寸下都学不起来。采样到的动作先按每通道标准化单位展开,再缩放到固定的均方根大小 epsilon,解码时还要乘回每通道隐变量标准差。
训练用分组强化学习,每句话采样 8 个动作,用冻结目标预测器的打分做奖励并做组内归一化,再用截断替代目标更新。因为攻击者只需要前向打分,不需要预测器梯度,所以任何预测器都能作为目标,这也是后面能横向比较 4 个预测器的前提。
神经编解码器 × 编解码往返输出: 神经编解码器指先把波形编码为连续隐变量再解码回波形的冻结模型;编解码往返输出指不加任何扰动、只过一遍编码再解码得到的信号,记为 x-hat,本文用它做刷分判定的基准,才能把编解码器自身带来的分数漂移和扰动带来的加分分开。
什么才算一次刷分:两条规则如何分工
判定刷分不用人工标注,靠两条规则同时成立。第一条是上限规则,被攻击输出的分数要比往返输出高出 0.3 MOS 以上。第二条是评审组规则,至少有一个独立度量相对往返输出变差超过容限,包括以原始输入为参照的 ESTOI、SI-SDR、SpeechBERTScore,以及用 Whisper 转写比较的词错误率。容限在原文中是 ESTOI 差 0.02、SI-SDR 差 1 分贝、SpeechBERTScore 差 0.02 等量级。两条规则都以住返输出为参照,才能把扰动效果分离出来。
一个输出只有分数涨但独立指标没变差,不算刷分;只有指标变差但分数没涨,也不算。论文把被判定为刷分的比例定义为攻击成功率,用它度量可攻击性。需要提醒的是评审组里有两个神经指标,并非完全独立,波形攻击的参照处理也不同,因此跨攻击家族的成功率不能直接比大小。
上限规则 × 独立评审组规则: 上限规则指被攻击信号的预测分要比往返输出高出阈值 tau 以上;独立评审组规则指至少有一个独立客观指标相对往返输出变差超过各自容限,两条同时满足才算一次刷分,前者管分数涨了多少,后者管音频是否真的没变好,缺一不可。
补丁如何用偏好对更新预测器
每次被判定为刷分的样本贡献一个偏好对,往返输出为优选侧,被攻击输出为拒绝侧。论文强调优选侧必须用往返输出而不用原始输入,否则模型可能学到编解码器伪影这种捷径,一个单种子探索性消融也支持这一点。更新时把原来的回归损失和一个间隔排序损失加在一起,间隔 m 取 0.5,权重为 1,要求模型对同一对的打分差至少拉开 0.5。所有历史轮次的刷分样本放在一个回放缓存里联合训练,避免只记住最新一轮。流程重复 3 轮,得到 R1 到 R3。
多空间变体同时从 3 种攻击空间收集样本,包括原 EnCodec 连续隐变量、第二种编解码器 DAC 的量化隐变量,以及最大扰动不超过 0.002 的波形白盒投影梯度下降攻击,所有样本共享同一个缓存。
组归一化优势分组强化学习策略 × 固定均方根扰动: 组归一化优势分组强化学习策略指本文攻击者用的训练方式,对同一句话采样一组动作并按组内归一化优势更新;固定均方根扰动指每次把隐变量偏移缩放到同一均方根大小 epsilon,攻击强度被固定住,不同预测器和不同轮次才有可比性。
偏好对 × 间隔排序损失: 偏好对指把往返输出记为更好、把被判定为刷分的输出记为更差而构成的 x-hat 优于 y 样本;间隔排序损失指在原来回归损失之外,要求模型对偏好对的打分差至少拉开间隔 m,否则给惩罚,补丁就是靠这个把刷分样本的分数压下去。
实验用哪些数据、模型和扰动强度
主预测器 R0 是 SSL-MOS,结构是 wav2vec 2.0 base 编码器加均值池化和线性头,在 BVCC 训练集 4974 句上用均方误差训练 8000 步,编码器和头用不同学习率,选验证均方误差最好的检查点。人类一致性在 13 个测试集上评价,包括 BVCC 测试集、VoiceMOS22 域外集、3 个 NISQA 集、SOMOS、TMHINT-QI、4 个 VoiceMOS23 赛道和 URGENT24 与 25 质量评价集。攻击者在 3 秒裁剪上训练 2000 步,扰动大小 epsilon 经验证集单独选为 0.5。
补丁每轮微调 1500 步,3 轮共 4500 步预算,3 个对照基线共享同样预算和损失,区别只在拒绝侧来源:高斯噪声对、波形投影梯度下降对,以及同样 epsilon 下的随机隐变量扰动对,后者没有强化学习也没有检测器。下游实验用一个 2,600,000 参数的短时傅里叶掩蔽增强器,先在 VoiceBank-DEMAND 监督预训练,再用分组强化学习后训练 2500 步,策略在 32 个等效矩形带宽频带上加逐帧偏移且不加散度惩罚,让奖励模型成为限制刷分的唯一因素。
种子、主要指标和判决规则在接触测试标签前预注册,多空间变体和消融是探索性的,修正基准是事后重分析。
四个常用预测器在同一强度下差多少
下面先看横向比较的公平条件:同一 EnCodec 隐变量空间、同一 epsilon 为 0.5、BVCC 测试集 500 句、每个预测器配 5 个独立训练的攻击者,指标是成功率均值、最坏成功率和平均加分,成功率越高、加分越大表示越容易被刷分。表前这段说明比较问题和指标方向,读表时注意偏移列表示编解码器自身带来的分数变化。
| Predictor | offset | mean ASR | worst ASR | mean gain |
|---|---|---|---|---|
| SSL-MOS (BVCC) | -0.10 | 0.205 | 0.252 | +0.191 |
| UTMOS22 | -0.07 | 0.057 | 0.076 | +0.144 |
| NISQA | +0.14 | 0.896 | 0.916 | +0.954 |
| DNSMOS OVRL | +0.02 | 0.136 | 0.200 | +0.124 |
表 1 显示 NISQA 平均成功率 0.896、最坏 0.916、平均加分正 0.954 MOS,SSL-MOS 平均 0.205、最坏 0.252,DNSMOS 平均 0.136、最坏 0.200,UTMOS 平均 0.057、最坏 0.076。预测器之间差一个数量级以上,最容易被刷的是常被当强化学习奖励的 NISQA。基准的影响也很具体,原始基准下 DNSMOS 看起来更易被攻,NISQA 看起来更难,方向正好相反。攻击者之间的离散相对较小,NISQA 5 个种子集中在 0.876 到 0.916,UTMOS 集中在 0.042 到 0.076,所以预测器排序比较稳,而防御比较更容易被种子噪声淹没。结论成立条件是黑盒隐变量攻击、固定中等强度、500 句规模,没有听感实验,不能推广到所有攻击家族。
左图把上述基准效应画了出来,右图把补丁轮次内的收敛情况画了出来,读图时先分清左右两块的纵轴都是成功率但样本集合不同。
看图路径: 1. 在左图比较同一预测器下原始输入基准与往返输出基准两根柱子的高低和误差棒;2. 在左图确认哪个预测器的攻击成功率明显高出一个量级;3. 在右图按轮次看单空间与多空间训练下各条折线是下降还是持平

论文图 2。原论文 Fig. 2::“(a) Benchmark of four common predictors at one perturbation size under the naive (x) and corrected (x) ceiling references; error bars span the five attackers, and the reference…”。
图 2 左图显示 4 个预测器在原始基准和修正基准下的两根柱子,误差棒跨 5 个攻击者,NISQA 柱子接近 0.9,UTMOS 最低,DNSMOS 和 NISQA 换基准后移动方向相反。右图显示训练集上本轮攻击者打上一轮预测器的成功率随轮次的变化,单空间回路在自家空间内下降,多空间训练下 DAC 和投影梯度下降攻击下降而 EnCodec 攻击持平,说明加固范围很窄。像素上能看清的只是趋势,辨不清的具体数值以正文表格为准。
闭环补丁在自家空间和未知空间各有什么表现
下面这张表回答补丁审计的核心问题:在修正基准下,用新训练的攻击者在测试集上重打,EnCodec、DAC 和波形投影梯度下降 3 个空间的成功率各是多少,以及和人评分的系统级排序相关在域内和域外如何变化。公平条件是补丁和基线共享 4500 步预算和损失,成功率越低越好,排序相关越高越好。表前这段交代比较对象和指标方向,读表时注意偏移列和域外平均的含义。
| offset | ASR by attack space | ASR by attack space | ASR by attack space | human agreement | human agreement | |
|---|---|---|---|---|---|---|
| Predictor | R(x^)−R(x)R(\hat{x})!-!R(x) | EnCodec | DAC | PGD | BVCC | OOD |
| R0 (no defense) | -0.09 ± 0.02 | 0.226 ± 0.205 | 0.065 ± 0.113 | 0.999 ± 0.002 | 0.922 ± 0.004 | 0.731 ± 0.006 |
| R1 | -0.06 ± 0.03 | 0.050 ± 0.048 | 0.161 ± 0.033 | 1.000 ± 0.001 | 0.911 ± 0.009 | 0.690 ± 0.014 |
| R2 | 0.00 ± 0.07 | 0.017 ± 0.006 | 0.141 ± 0.025 | 1.000 ± 0.000 | 0.918 ± 0.003 | 0.682 ± 0.008 |
| R3 (EnCodec loop) | -0.27 ± 0.25 | 0.137 ± 0.179 | 0.127 ± 0.031 | 1.000 ± 0.000 | 0.920 ± 0.001 | 0.637 ± 0.046 |
| R3multi (multi-space) | 0.95 ± 0.16 | 0.082 ± 0.107 | 0.016 ± 0.026 | 0.841 ± 0.089 | 0.914 ± 0.003 | 0.552 ± 0.015 |
| noise pairs | -0.09 ± 0.01 | 0.270 ± 0.107 | 0.230 ± 0.028 | 1.000 ± 0.000 | 0.917 ± 0.004 | 0.722 ± 0.013 |
| PGD pairs | -0.08 ± 0.02 | 0.223 ± 0.057 | 0.225 ± 0.044 | 0.969 ± 0.025 | 0.909 ± 0.001 | 0.635 ± 0.009 |
| random-latent pairs | -0.03 ± 0.03 | 0.019 ± 0.016 | 0.200 ± 0.053 | 1.000 ± 0.000 | 0.922 ± 0.004 | 0.696 ± 0.010 |
表 2 显示 EnCodec 回路把自家空间成功率从 R0 的 0.226 降到 R1 的 0.050 和 R2 的 0.017,但 R3 回升到 0.137,且 3 轮差值在 3 个种子下符号不一致,预注册的主假设在修正基准下不成立。换到未知 DAC 攻击者,补丁后反而比不防御更差,从 0.065 升到 0.13 到 0.16 区间,白盒投影梯度下降几乎对所有 EnCodec 训练的防御全破。只有多空间训练能防住 DAC 到 0.016 并让投影梯度下降降到 0.841,但代价是重建偏移正 0.95 和域外平均排序相关掉到 0.552。EnCodec 列 R2 为 0.017 ± 0.006,random-latent pairs 为 0.019 ± 0.016,随机基线是 3 个同预算基线中最低且与闭环相当,说明强化学习和检测器没有带来额外增益。
域内系统排序基本保住,R3 相对 R0 只差 0.002,但语句级均方误差上升、域外平均从 0.731 一路掉到 0.637, noisy 语音集上掉得最多,论文推测是模型把受扰音频当坏样本学过了头,连带到真实噪声音频,仍属推测待验证。
下游增强器用打过补丁的奖励还会刷分吗
下面这张表回答下游实际风险:同一个小增强器分别用未防御奖励、打过补丁的奖励和随机对基线做后训练,相对监督预训练的变化是多少。奖励涨是优化目标,PESQ、ESTOI 和 SI-SDR 掉表示听感相关指标变差,方向是越高越好对应下降为坏。表前这段说明比较问题是奖励能否在涨分同时保住客观质量,读表时注意自家奖励和其他指标要分开看。
| Measure | R0 | R3 | random-latent pairs |
|---|---|---|---|
| Δ\Delta own reward | 0.263 ± 0.010 | 0.269 ± 0.028 | 0.334 ± 0.051 |
| Δ\DeltaPESQ | -0.226 ± 0.170 | -0.034 ± 0.126 | 0.019 ± 0.050 |
| Δ\DeltaESTOI | -0.057 ± 0.010 | -0.038 ± 0.013 | -0.043 ± 0.006 |
| Δ\DeltaSI-SDR (dB) | -6.1 ± 1.4 | -5.8 ± 1.4 | -5.7 ± 0.6 |
| Δ\DeltaDNSMOS | -0.075 ± 0.031 | -0.076 ± 0.056 | -0.075 ± 0.043 |
| Δ\DeltaNISQA | 0.335 ± 0.186 | 0.300 ± 0.072 | 0.468 ± 0.059 |
| Δ\DeltaUTMOS | 0.018 ± 0.006 | 0.057 ± 0.030 | 0.076 ± 0.011 |
表 3 显示对未防御 R0,增强器呈现教科书式刷分,自家奖励涨 0.263 而 PESQ 掉 0.226、ESTOI 掉 0.057、SI-SDR 掉 6.1 分贝。对 R3,自家奖励同样涨 0.269 但 PESQ 只掉 0.034,R2 行为类似,说明这是补丁共有性质而非某一轮偶然,随机对基线同样做到 PESQ 涨 0.019。代价是 SI-SDR 在 3 种奖励下都掉 5 分贝以上,DNSMOS 都掉 0.075 左右,而 NISQA 和 UTMOS 在所有奖励下都涨,说明这些交叉指标发现不了这次刷分。R3 能给攻陷 R0 的增强器打低分,但给攻陷自己的增强器打高分,且没有响度匹配对照,分不清是识别出退化还是单纯给退化音频打低分。结论只在该小模型、该训练步数和该测试集下成立。
阈值、间隔与训练不对等会不会改变排序
论文做了几项对照来确认排序不是调参假象。因为补丁间隔 0.5 大于检测阈值 0.3,作者在 0.1 到 1.0 范围内扫描阈值,防御排序不变,但 R3 在阈值 1.0 处仍有 0.045 的成功率残留,且 90 分位分数差大于 R0,说明大额刷分尾巴还在。训练强度上有多处不对等,评估用 50 步投影梯度下降,而多空间回路内只用 10 步、基线只用 5 步,防御见过的攻击弱于测试时的攻击;回放缓存只有 5.8k 到 8.9k 对,而随机对有 19.9k 对,数量上偏向基线。即便如此随机基线仍持平,结论反而更稳。优选侧用原始输入还是往返输出的单种子消融显示,用原始输入时第 3 轮成功率 0.172,用往返输出时 0.010,支持必须用往返输出做优选侧,但样本只有一种子,只能当探索性证据。
这些结论在什么边界内才成立
论文自己给出两个主要限定。第一,攻击是黑盒且温和的,对 SSL-MOS 的刷分只让 ESTOI 动负 0.023、SI-SDR 动负 1.034 分贝,两个独立裁判认为听感变化边缘,而波形白盒攻击能把 UTMOS 推高 0.802,全文没有听音实验,所以基准只在该攻击家族内排序预测器。第二,检测器并非完全独立,其中两个评审指标本身是神经模型,波形攻击的参照就是输入本身,跨家族成功率不可比。补丁研究只有 3 个种子、一个预测器家族,约 46 个 A100 小时,R2 优于 R3 也说明 3 轮是预注册固定而非优选。
此外域外集之间并不独立,TMHINT-QI 和 VoiceMOS23 第三赛道共享条件网格,平均相关要打折看。容易误解的是把成功率 0.90 读成音频坏了 90%,实际它只是被判定为刷分的句子比例,且攻击本身温和;也不能把域内排序保住读成校准保住,语句级均方误差其实上升了,对奖励模型很关键。
复现第一步做什么与还缺什么
复现应从测量口径做起,而不是先跑补丁。第一步是固定编解码器和 epsilon,分别算出零扰动往返输出和被攻击输出的分数与独立指标,先复现偏移列和成功率定义,再为每个预测器训练 5 个不同种子的攻击者并取最坏值。关键超参数要保留:epsilon 为 0.5、阈值 0.3 MOS、间隔 0.5、每轮 1500 步、组大小 8、裁剪 3 秒、学习率等设置,以及回放缓存累积全部历史样本。信息条件上攻击者只需前向分数,白盒投影梯度下降才需梯度。
论文正文写明释放代码、预注册和运行输出,但本次没有绑定且完成网络校验的作者资源,不能写成当前可用或已公开,需要补 1 次来源验证。还需要补的验证是听音实验确认温和扰动是否真的可闻、响度匹配对照分离打分下降的原因,以及更多种子和预测器家族下的重复。
什么时候值得尝试这种测量与补丁
当你要把某个语音质量预测器当奖励或筛选器用,先值得尝试的是这套测量:固定扰动大小、换成往返输出基准、训练多个攻击者取最坏成功率,再决定选 UTMOS 这类难刷分的还是 NISQA 这类易刷分的,相关性高不能代替这一步。当你考虑闭环打补丁,要预期它只硬化自家空间,换一种编解码器或波形攻击就可能失效,且域外一致性会掉,随机同强度扰动对可能是更便宜的起点。多空间训练是唯一拓宽覆盖的办法,但要接受重建偏移和更大的域外损失。
最终选择取决于部署环境:若攻击空间单一且域内排序最重要,补丁加随机对都可试;若要面对未知扰动和噪声域,先补听音验证和域外评估再谈部署。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses