📄 Transformer 该往回看多远:民谣乐曲中的重复与拷贝
英文题目:How Far Back Should a Transformer Look? Repetition and Copying in Music Sequence Models
标签:#符号音乐生成 | #自回归模型 | #Transformer | #模型评估
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.5/1.5
👥 作者与机构
- Amir Fathi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是量化到固定网格并只保留最高音的单声部符号音乐序列,输出是下一个token或下一个二值隐步骤的概率分布,难点在于判断更长历史带来的是新信息,还是只重复了已出现过的段落。作者对每个上下文长度单独训练小型因果Transformer并在相同目标位置上比较测试负对数似然,同时训练直接预测token的模型和预测自编码器隐步骤的模型,后者每个隐步骤对应互不重叠的6个token,且注意力带宽被限定为恰好依赖最近T个输入。重复滞后统计记录目标前16个token的历史在窗口内最近一次出现的位置,用于判断重复是否进入可见范围,再用擦除更早出现位置和在测试时截断远端历史检验因果性。在Nottingham民谣相同目标位置的测试中,6个token上下文的token预测器与336个token上下文的相比,测试负对数似然从1.391比特每token降至0.405比特每token,降幅0.986比特每token即71%。在同样Nottingham相同目标位置测试中,简单复制基线与长上下文增益相比,以测试负对数似然衡量恢复了约94%的降幅,而336个token训练模型在测试时截断远端历史则失去大部分增益,O’Neill’s可比长曲上6到336个token的降幅为71%共1.195比特每token、复制基线恢复97%。在两套民谣相同目标位置测试中,短长上下文相比隐预测器的测试负对数似然降幅分别为46%和50%。在MAESTRO演奏和MusicNet乐谱相同目标位置测试中,16个token重复稀少使token预测器6到336个token的总增益更小、仅0.296比特每token和0.445比特每token,且多在96个token内实现并主要来自无重复目标。结论只适用于展开重复记号的乐谱渲染表示,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
要预测什么:单声部记谱的下一个事件
论文研究符号音乐的自回归预测,也就是根据前面已经出现的音符去预测下一个位置出现什么。输入是量化后的单声部序列:每首曲子按四分音符切成每拍 4 步,一个 4/4 小节对应 16 步,每步只保留当时 sounding 的最高音,休止记为词元 0,其余 47 个词元对应训练集中出现最多的连续音高。MAESTRO 的钢琴演奏因此只保留了上声部,且没有专门的起音符号,延长音和同音反复会被映射成同样的词元串。
输出是对下一个词元的概率分布,用测试负对数似然(NLL)衡量,数值越低表示预测越准,单位是每个词元多少比特或每个潜在位多少比特。两类预测器的 NLL 定义在不同随机变量上,论文明确说只能比较曲线形状,不能直接比数值大小。研究者关心的是允许看到的最长前文从 6 个词元放宽到 336 个词元时,预测性能如何变化,以及长上下文模型到底利用了什么信息。
已有路线为何默认看很远,又为何有人只看附近
一类工作让模型注意整首曲子,例如 Music Transformer 用相对注意力处理完整序列,Perceiver AR 把符号音乐上下文做到数千词元,MuPT 和 NotaGen 把语言建模方法扩展到乐谱。另一类工作的动机是最近历史最重要,例如 Anticipatory Music Transformer,但它没有直接量化到底需要多长历史。更早的 WaveNet 和时间卷积网络说明有限感受野可以与循环结构竞争。在语言建模中,已有研究通过截断或扰动历史发现约 200 词元内仍有可用信息,神经缓存能利用远处词汇重复,超过 2K 词元的额外上下文主要帮助那些可以直接从远处拷贝的词元。
与音乐直接相关的是两项工作:Yi 等人报告 MAESTRO 上全序列模型会利用超过 1024 词元局部窗口的信息;Ghoshal 等人比较 LSTM 与 Transformer,发现 LSTM 能抓住局部规律但丢失长程结构。本文的对照是训练一系列最大上下文不同的模型,而不是只缩短同一个模型的测试历史,再辅以针对已训练长上下文模型的编辑与限制干预。论文还把自己的拷贝现象类比为语言模型中突然出现的 induction heads,但声明因为只干预输入而不分析注意力,所以只是类比而非认定。
核心问题:放宽历史上限是否真有用,有用在哪里
论文要回答两个经验问题。第一,把可用历史从很少放宽到 336 个词元,预测性能如何变化。第二,这种变化由音乐表示的什么性质决定。实验设计把最大可及历史作为实验因素,在每个上下文长度上单独训练一个模型,所有长度在完全相同的目标位置上打分。作者提醒,这种做法度量的是在固定训练流程下每个上限能达到的性能,本身不能说明单个已训练模型实际用了多少上下文,因此必须加上对已训练长上下文模型的两种干预。
表示层面同时做两套预测器,一套直接预测原始词元,一套预测二进制自编码器码,每 6 个词元对应一个潜在步,序列缩短为六分之一,用来复现早期草稿的 2 阶段设定。划分上要求整首曲子或整场演奏只属于一个子集,并做了近重复分组,避免同曲异名泄漏。
最大上下文长度 × 有效利用: 最大上下文长度指训练和评测时允许看到的最多前文词元数,是实验旋钮;有效利用指单个已训练模型在测试时真的依赖远处信息,二者搭配才能区分能看到与真正在用,组合后需要用删改远处历史的干预来验证。
整体流程:先做表示,再按上下文长度分别训练预测器
流程分三步。先把 MIDI 按各自的速度图量化成固定网格,Nottingham 取旋律声部,O’Neill’s 用 music21 展开反复记号,MusicNet 用各自文件的速度图,MAESTRO 是固定 120 拍因而是 125 毫秒网格。再训练自编码器,把每 48 词元块编成 8 个潜在步,每步 64 位二进制,编码与解码都只看对应的 6 词元区间,用梯度检查确认感受野不交叠。最后在每个上下文长度上分别训练词元预测器和潜在预测器,上下文取 6、18、48、96、192、336 个词元,对应潜在步数为 1、3、8、16、32、56。Nottingham 和 O’Neill’s 的评测窗口是 384 词元、最后 48 词元为目标,保证最长上下文恰好是第一个目标的全部可用历史。
MAESTRO 和 MusicNet 用 480 词元非重叠窗口、最后 144 词元为目标。每个配置用 3 个随机种子训练,报告均值与样本标准差,长度间差异再用按曲目重采样的配对自助区间刻画。
词元预测器 × 潜在步预测器: 词元预测器直接对 48 个音高加休止符号做分类预测,潜在步预测器先把每 6 个词元编成 64 位二进制码再逐位预测,二者搭配可以在原始序列和缩短六倍的序列上检验同一上下文效应,组合后能看出增益是否依赖具体表示。
如何度量重复:16 词元历史的最近复现距离
论文用重复滞后把重复变成可计算的位置统计。对窗口中每个目标,取它前面 16 个词元作为历史,在窗口内向前找历史完全相同的最近位置,距离记为滞后。若上下文长度为 T,当滞后加 16 不超过 T 时,称该重复进入视野,此时模型既能看到早先的历史片段,也能看到它后面的延续,而当前目标本身从未暴露。分箱切在 1 到 32、33 到 80、81 到 176、177 到 320,恰好分别在 48、96、192、336 词元时完整进入视野。16 词元在 Nottingham 网格上对应一个 4/4 小节,在 MAESTRO 网格上对应 2 秒,论文还用 8 和 32 词元历史重复了分析。
潜在预测器的目标步只以前面的潜在步为条件,因此要求匹配位置至少早 6 词元,保证候选延续在目标步开始前结束。单音长保持的歷史单独处理,因为它几乎处处匹配。
\[\ell_{t}=\min\{\,t-j\;:\;17\leq j重复滞后 × 拷贝候选: 重复滞后指目标前 16 个词元的历史在过去最近一次出现的位置距离,拷贝候选指那次出现之后紧跟的词元,二者搭配把抽象的重复变成可检索的位置加内容,组合后可以直接检验预测是否在抄写那个候选。
模型与训练:两层 Transformer 与非重叠自编码器如何学
所有预测器是同一两层因果 Transformer,预归一化块,隐宽 384,4 头,前馈宽 768,GELU 激活,丢弃率 0.2,注意力分数带随偏移学习的位置项,因此参数量随上下文略增,336 词元的词元预测器约 2.50M 参数。注意力按层限带,第一层只看最近至多 18 词元或 3 潜在步,第二层覆盖剩余远处历史,两层带宽满足带宽和减一等于上下文,梯度检查确认输出恰好依赖前 T 个位置。这种不对称设计是为了检索:第一层编码局部匹配模式,第二层直接注意远处对应位置。
早期均分带宽的实现只能有效拷贝约一半标称上下文内的重复。潜在预测器把正负 1 比特经线性层读入,对每位输出独立逻辑回归。词元预测器嵌入离散词元并输出 48 类分布,MAESTRO 去钳制重训用 89 类。训练用 AdamW,学习率 0.001,权重衰减 0.0001,批 32,梯度裁剪 1.0,训练目标带 0.06 标签平滑,验证 NLL 20 轮不改善则停止,评测时不加标签平滑。自编码器用步长 6 卷积实现不交叠,目标是重建交叉熵加退火的正则项,训练加噪声并用直通估计器通过符号函数,Nottingham 加正负 6 半音内的在线移调增强。
数据划分与评测条件如何保证公平
Nottingham 按曲子 70/15/15 划分,划分前把共享小曲子一半以上非常量 16 词元模式的曲子并组,避免同曲异名跨子集,词元化后再执行一次,4 首会跨界的曲子被整体搬到一组最多的子集。O’Neill’s 同样处理,MusicNet 按作曲家加乐章分组,MAESTRO 用官方划分。窗口只在划分固定后抽取,Nottingham 短于 384 词元的曲子在所有长度上都被排除,而不是只在长上下文上被排除。Nottingham 训练窗口 2789 个,测试目标所在的曲子 133 首;O’Neill’s302 首测试曲中 129 首够长。
Nottingham 训练集小因而在线移调,MAESTRO 和 MusicNet 窗口多而不移调。指标方向都是越低越好,词元是每个词元比特,潜在是每位比特。长度间差异报告按测试曲目重采样的 95% 区间,因为同曲目标相关。生成部分是次要诊断,用相邻重复率、词元熵和块内不同词元数三统计量到训练参考的距离衡量,不读作音乐质量。
主扫描:民谣陡降而演奏早早放缓
下图把 4 套语料的测试 NLL 除以各自 6 词元的值画成相对曲线,横轴对数,虚线标 96 词元,末端标签是 6 到 336 的下降比例。读图时先看整体斜率,再看 96 词元前后是否转折,最后看种子散点是否分叉。Nottingham 词元曲线先升后陡降,O’Neill’s 单调陡降,MusicNet 和 MAESTRO 则平缓。
看图路径: 1. 先看横轴对数上下文与纵轴相对 6 词元的比值,越低表示相对起点下降越多;2. 比较 Nottingham 与 O’Neill’s 在 96 词元后的陡降和 MAESTRO 的平坦;3. 注意 96 词元处的虚线与 Nottingham 词元曲线的种子散点分叉
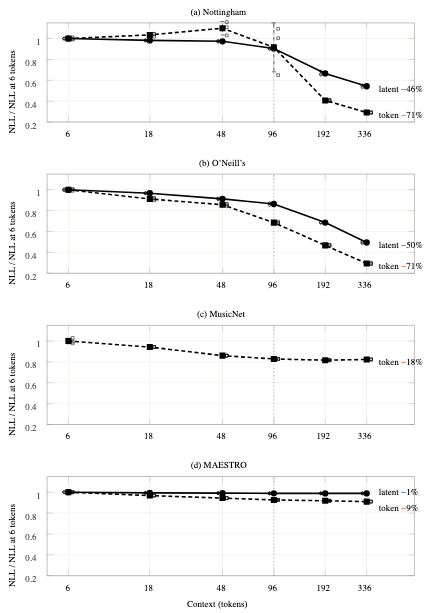
论文图 1。原论文 Fig. 1::“Test NLL relative to its value at 6 tokens of context for (a) Nottingham, (b) O’Neill’s, (c) MusicNet and (d) MAESTRO.”。
图中可见 Nottingham 潜在曲线从 6 到 336 单调下降,词元曲线在 96 词元处种子分歧很大,192 之后两条曲线都大幅走低;MAESTRO 两条曲线到 96 词元已走完大部分行程,之后几乎水平。具体数字见下表,该表在相同目标位置上比较不同最大上下文的测试 NLL,各长度独立训练但打分位置完全相同,指标越低越好。
| 条件与指标 | Nottingham 潜在 每位比特 | Nottingham 词元 每词元比特 | O’Neill’s 词元 每词元比特 | MAESTRO 词元 每词元比特 | MAESTRO 潜在 每位比特 |
|---|---|---|---|---|---|
| 6 词元起点 | 0.857 | 1.391 | 1.692 | 3.283 | 0.887 |
| 96 词元 | 0.775 | 1.274 | 1.160 | 3.040 | 0.877 |
| 192 词元 | 0.571 | 0.567 | 0.791 | 3.013 | 0.877 |
| 336 词元 | 0.465 | 0.405 | 0.497 | 2.987 | 0.877 |
| 6 到 336 下降 | 0.392 | 0.986 | 1.195 | 0.296 | 0.010 |
对比可见 Nottingham 词元从 6 到 336 下降 0.986 词元比特,降幅 71%,潜在下降 0.392 位比特;O’Neill’s 词元下降 1.195 词元比特同样 71%;MAESTRO 词元从 3.283 到 2.987,96 词元已完成 82%,96 到 336 仅再降 0.054,潜在从 6 词元 0.887 到 336 词元 0.877,6 到 336 下降约 0.010,其中 96 到 336 仅变化 0.0004 且区间包含零。MusicNet 词元从 2.512 到 2.067,降幅 18%,97% 在 96 词元前完成,336 反而比 192 差 0.017。结论只到 336 词元,更长未测;Nottingham48 到 96 段均值受优化双峰影响,O’Neill’s 只含够长的 129 首测试曲。
增益落在何处:进入视野才变好
下图是 Nottingham 按重复滞后分列、按上下文分行的 NLL 热图,黑线左侧为重复进入视野。读图说明是先固定一列看随行增大何时变深,再对比无重复列是否几乎不变,最后比较词元与潜在两块是否同向。
看图路径: 1. 按列看重复滞后分箱,按行看上下文增大,找黑线左侧进入视野的格子;2. 对比进入视野前后同一列的数值是否跳变;3. 注意无重复列在长上下文下几乎不变
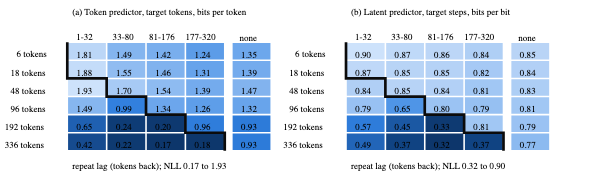
论文图 2。原论文 Fig. 2::“Test NLL on Nottingham by repeat lag (columns) and context length (rows), mean over three seeds, for (a) the target tokens of the token predictor and (b) the target latent steps…”。
可见词元块中 81 到 176 列在 192 行突然变深,177 到 320 列到 336 行才变深;潜在块同样在对应行转折;无重复列始终浅色。具体到数字,6 词元时各重复箱在 1.24 到 1.81 之间,192 词元时视野内的 33 到 80 和 81 到 176 降到 0.24 和 0.20,而视野外的 177 到 320 仍为 0.96,无重复为 0.93,到 336 时 177 到 320 进入视野降到 0.18。潜在在 192 时 81 到 176 为 0.33 而 177 到 320 为 0.81,到 336 后者降到 0.37。下表整理重复占比与增益归属,对比同一目标集合按滞后划分后总下降中有多少来自有重复目标,份额越高越说明增益集中。
| 语料与目标类型 | 336 视野内有重复份额 | 总下降中来自有重复 | 总下降中来自无重复 | 无重复占比 | 延续可抄性 |
|---|---|---|---|---|---|
| Nottingham 词元 | 71.0% | 87% | 12% | 28.3% | 97% |
| MusicNet 词元 | 10.5% | 25% | 74% | 86.4% | 中 |
对比显示民谣约七成目标在 336 视野内有重复,且其中 97% 下一词元与早先延续相同,总下降近 90% 来自这些目标;MAESTRO 仅 0.8% 有重复,98% 下降来自无重复目标。8 词元历史下 73% 有重复占 84% 下降,32 词元历史下 60% 占 74%,说明结论不依赖 16 的特定选择。移调后才匹配的占 0.9%,336 模型在其上得 1.08 反而不如无重复的 0.93,表明没有跨调拷贝。滞后只测原样复现,装饰变体未度量。
擦除与拷贝基线:拿掉来源增益是否消失
关联之后需要因果检验。下图是擦除实验的柱状图,每组三根柱子为保持原样、改写无关片段、改写重复来源。读图时先看擦除柱是否抬高,再看对照柱是否与干净柱齐平,最后看 4 个语料加长度组合是否一致。
看图路径: 1. 每组三根柱子分别对应保持原样、改写无关片段、改写重复来源;2. 看擦除柱是否显著抬高而对照柱与干净柱齐平;3. 对比词元与潜在两种预测器是否呈现同一模式
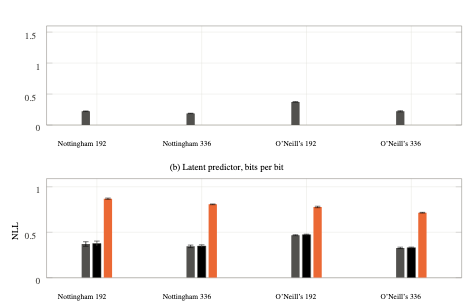
论文图 4。原论文 Fig. 4::“The erase test of Table IV as bars: test NLL of the targets with a repeat in view when the context is left as it is (clean), when as many unrelated spans are overwritten…”。
可见所有组都是擦除柱高耸而对照柱不动,词元上差异更大。下表给出具体 NLL 与拷贝基线回收率,在相同打分目标上比较显式检索能解释多少长上下文改进,基线只用不超过 336 的历史并在验证集拟合插值权重,指标仍是越低越好。
| 模型与上下文 | 干净 NLL | 擦除后 NLL | 对照 NLL | 注入音概率变化 | 拷贝基线回收 |
|---|---|---|---|---|---|
| Nottingham 词元 336 每词元比特 | 0.19 | 1.06 | 0.19 | 0.3% 到 62% | 94% |
| Nottingham 潜在 336 每位比特 | 0.35 | 0.81 | 0.35 | 不适用 | 不适用 |
| O’Neill’s 词元 336 每词元比特 | 0.22 | 1.24 | 0.22 | 0.4% 到 71% | 97% |
| MAESTRO 词元 拷贝基线 | 不适用,6 词元 3.283,无干净擦除对照 NLL 报告 | 不适用 | 不适用 | 不适用 | 11% |
| MusicNet 词元 拷贝基线 | 不适用,18% 匹配目标上基线 0.88 对应 336 个模型 1.60 和 6 个模型 2.62 | 不适用,基线增益占总下降 72% | 不适用,变压器在匹配目标上获总下降 42% | 不适用 | 72% |
对比显示 336 词元词元模型在重复目标上擦除后从 0.19 升到 1.06,接近无重复的 0.93,而对照仍为 0.19;只替换延续音时模型给注入音的概率从 0.3% 升到 62%,说明延续由早先位置决定。简单拷贝基线把 6 词元模型与最近匹配后继的点质量混合, backs off 从 32 到 16 到 8 词元,在 Nottingham 做到 0.469,相对 6 词元的 1.391 与变压器的 0.405,回收 94%,只用 16 词元匹配也回收 83%。O’Neill’s 回收 97%,MAESTRO 6 词元为 3.283,拷贝基线仅回收 11%,无干净擦除对照 NLL。
MusicNet 基线回收 72%,其中 0.88 仅是存在 32/16/8 词元匹配的 18% 目标上的基线值,对应 336 个模型 1.60 和 6 个模型 2.62,72% 是基线增益占总下降份额,42% 是变压器在匹配目标上获得份额,均不是干净擦除对照 NLL,因此基线在那里只说明可检索潜力而非机制相同。五次随机 donor 抽样下擦除值波动仅千分位,结论对随机性不敏感。
下面把重复可得性与下降来源并列,比较民谣与演奏语料在相同 336 词元可见性定义下差异有多大,以及下降是否集中在有重复的目标上。
| 语料与预测器 | 可见重复目标占比 | 无重复目标占比 | 重复目标对下降的贡献 | 无重复目标对下降的贡献 |
|---|---|---|---|---|
| Nottingham 词元 | 71% | 28.3% 不在 320 词元内 | 87% | 12% |
该对照说明 Nottingham 多数目标在 336 词元内可见重复且下降集中于这部分,而 MAESTRO 几乎没有可见重复,来源只直接给出无重复贡献 98%,重复贡献未直接报告、隐含约 2%,因此长上下文增益是否出现与可复制片段的多寡直接相关,但跨语料的表示与采样差异仍限制了因果外推。
擦除干预 × 对照干预: 擦除干预指把上下文中所有与目标历史相同的 16 词元段及其后继一起改写,对照干预指改写同样数量和长度但位置无关的片段,二者分工是因果检验与破坏量控制,组合后才能说性能下降来自丢了可抄的内容而非一般性破坏。
单个长模型去掉远史:优势是否随之丢失
扫描比较的是分别训练的模型,还需看单个 336 模型在测试时被剥夺远史会怎样。两种干预是只给最近 R 个词元的截断,和保留长度但把久远位置换成别曲的替换,都不重训。Nottingham 上全历史 0.405,限到 192 时截断 0.576、替换 0.591,接近直接训练的 192 模型的 0.567;限到 96 时升到 1.008 和 1.078。有重复目标从 0.190 升到 192 时的 0.404 和 96 时的 0.951,无重复仅从 0.933 到 0.997 和 1.146,说明退化集中在可抄目标。
O’Neill’s 全历史 0.497,限 192 时 0.861 和 0.877,限 96 时 1.460 和 1.491,重复目标从 0.223 到 0.692 和 1.406。MusicNet 从 2.067 到 96 时 2.115,MAESTRO 从 2.985 到 3.016,接近各自 96 扫描值,符合大部分增益已在 96 前完成。潜在用替换时 Nottingham 从 0.465 到 192 的 0.571 和 96 的 0.837,与独立训练的 0.571 和 0.775 定性一致,直接截断在 6 和 18 时超过 1 位比特故只报替换。6 和 18 处替换模型差于直接训练的小上下文模型,与从未见过混合历史的分布偏移一致。未胜出项是 Nottingham96 的替换模型反而好于部分直接训练的 96 个模型,因为后者并非都学会拷贝。
截断历史 × 替换历史: 截断历史指测试时只给最近 R 个词元,替换历史指保留 336 长度但把久远位置换成别曲的词元,二者都是限制单个长上下文模型可见历史的干预,前者改变长度后者保留长度,组合后可以区分信息丢失与输入格式偏移的影响。
生成是次要诊断,距离定义如下,符号先说明:相邻重复率与词元熵刻画表面统计,块 variety 计数不同词元数,距离是三者标准化偏差的平均。
\[d(S)=\frac{1}{3}\sum_{s\in\{r,H,u\}}\frac{\lvert\bar{s}_{S}-\mu_{s}\rvert}{\sigma_{s}},\]用 100 首测试曲首 336 词元做引子生成 480 词元,温度在验证集上逐模型调优。短上下文生成几乎无段落重复,重复率至多 0.01 而真实约 0.50;长上下文词元在 192 和 336 达到距离 0.25 和 0.29、重复率 0.41,潜在改善更慢。最接近的一组为 0.19,36 组中 0 组落入从头切的真实带 0.03 到 0.17,是否算匹配取决于真实流从何处切,因此不声称匹配。温度 1 时所有模型更远,只有 192 和 336 产生少量复现。
为何 96 词元不稳定:拷贝是突然学会的
Nottingham 词元在 96 词元处均值 1.274 而种子标准差 0.326,一个种子到 0.90 并在有重复目标上得 0.55,另外两种子在重复目标上仅 1.27 和 1.31。固定 200 轮无早停的 10 个新种子显示,6 个在 41 到 172 轮间验证 NLL 下跌超 0.2 比特,5 个落到 0.89 到 0.99,1 个到 1.26,其余 4 个停在 1.34 到 1.40 但仍在重复目标上好于无重复。把主扫描早停规则套到这些曲线上,会在 transition 前停掉 6 个中 2 个。192 词元 10 个全在 34 到 60 轮下跌并收敛到 0.55 到 0.56,主扫描 192 和 336 也都在 31 到 49 轮下跌。因此 96 词元约一半运行在 200 轮内学会拷贝,192 以上则全部学会。
是否移调也影响稳定性:无移调时 336 均值 0.805 而标准差 0.252,只有一个种子强拷贝;有移调时 192 和 336 在 95 到 178 轮才最优但 3 个种子都学会,336 标准差降到 0.006。潜在在所有设置下标准差不超过 0.015,更稳定。平均池化的 v5 在 Nottingham 从 48 的 0.843 恶化到 336 的 0.891,而因果潜在改进到 0.465,说明平均读出难以检索特定远处延续,表观饱和可能来自架构而非数据无信息。下图上为 10 条验证曲线,下为每次运行的测试点,读图先找彩色下跌线与灰色未下跌线的分叉,再看早停短横是否截在下跌前。
看图路径: 1. 上图看 96 词元十条验证曲线中哪些在平台期后突然下跌;2. 注意圆圈标记的下跌时刻与短横标记的早停时刻的先后;3. 下图对比早停三点与固定 200 轮十点的分布差异
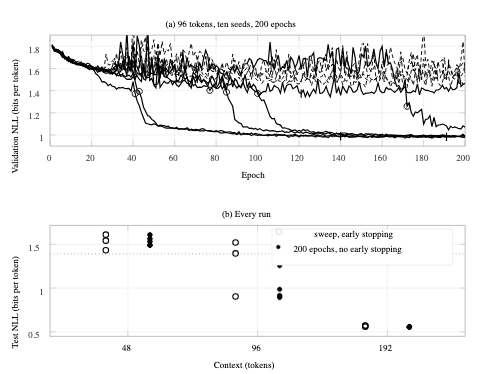
论文图 6。原论文 Fig. 6::“Seed spread of the Nottingham token predictor.”。
可见下跌 abrupt 且时刻分散,早停与种子共同决定 96 处的均值,解释该段结果时必须提双峰而非只报均值。
结论在什么条件下才成立,有哪些边界
适用条件很具体。表示是单声部最高音加固定网格,无起音符号,两套民谣都是把书面反复记号展开成逐音重复的渲染乐谱,重复段因此在词元层面完全相同;MAESTRO 是每 125 毫秒采样的富有表现的演奏,很少逐词元复现。语料间重复份额与下降幅度只是 4 个点的描述性共变,不是统计检验。目标采样也不同,跨语料用统一规则重算后 Nottingham71.8%、O’Neill’s73.5%、MusicNet10.4%、MAESTRO0.8%,与扫描目标估计接近。
窗口固定 384 词元排除了短曲,Nottingham133/154 首、O’Neill’s129/302 首参与,O’Neill’s 被排除的曲子本身重复率更低且更短,前 256 词元内保留与排除分别为 43% 与 23%,因此 O’Neill’s 下降刻画的是够长且更重复的子集。模型约 2.5M 参数、最多数百万词元、上下文至多 336,更长、更大或更久训练可能改变曲线,18 到 96 段对优化敏感。重复分析只测原样 16 词元历史,移调单独处理,装饰性近似重复未测。MusicNet 只有词元预测器且测试仅 43 首,自助区间较宽。
MAESTRO96 到 336 仍有 0.054 的正增益且几乎全在无重复目标上,信息来源未识别,与 Yi 等人超 1024 词元的发现不冲突,因为表示、网格和参数量都不同。
复现第一步:先锁划分与感受野再跑扫描
复现先做划分与校验。MAESTRO 用官方划分,其余按曲或乐章分组,共享小曲子一半以上非常量 16 词元模式则连边合并,连通分支后按固定种子 42 取 70/15/15,词元化后再执行一次,跨界组整体搬到成员最多的子集。统计非恒定 48 词元测试块在训练中原样出现的比例,应接近零。窗口抽取只在划分固定后进行,Nottingham 与 O’Neill’s 每 48 词元起一个 384 窗口、最后 48 为目标,MAESTRO 与 MusicNet 非重叠 480 窗口、最后 144 为目标,短于窗口的曲子全部排除。自编码器用步长 6 卷积保证每潜在步只看 6 词元,梯度检查确认。
预测器两层带宽满足带宽和减一等于上下文,同样梯度检查。训练种子 42、7、0,AdamW 加标签平滑 0.06,验证 NLL 20 轮不升则停,评测去掉平滑。分析脚本先算滞后分布,再做擦除与对照、拷贝基线权重在验证集网格搜索、单模型截断与替换。来源方面,论文未发现完成 HTTPS 验证的绑定资源,不得声称代码模型数据已公开;可写的是作者在可复现说明中称代码、划分清单与每次运行输出可向作者索取,数字表格由单一分析脚本生成。
代码、权重、数据是三件事,需分开确认。
何时值得试长上下文,还缺哪项验证
当你的表示是量化渲染乐谱且存在展开的反复段时,值得把上下文放到 192 到 336 并检查重复滞后分布,因为论文中七成目标有视野内重复且增益集中于此,简单拷贝基线能回收 90% 以上;当数据是富有表现的演奏或已去除展开重复时,长上下文到 96 后收益很小,应优先调局部建模与训练预算。复现第一步是重建源不交叠划分与非重叠感受野,再跑 6 到 336 的独立训练扫描并在相同目标上打分。还缺的验证是把书面反复折叠后重测,看增益是否消失。
在同一演奏录音的记谱与演奏两种表示上对比;以及在更大模型与超 336 上下文上确认 MAESTRO 残余增益的来源。常见误解是把相对下降 71% 读成绝对质量高低,实际上词元与潜在的比特定义不同,只能比形状;把单个长模型截断差读成训练失败,实际上包含分布偏移;把生成距离接近真实带读成音乐质量好,原文明确不作此读。
早期 16 词元饱和的教训是检查泄漏划分、潜在交叠目标、平均池化读出和按文件估计速度四项,缺证据不等于技术有错,相关也不等于因果,未测延迟成本前不承诺效率改善。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses