📄 BanglaBox:面向孟加拉语的语音均衡语料与基础模型适配
标签:#文本到语音 | #SFT | #数据集 | #语音克隆 | #零样本
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Emtiaz Uddin Ahmed:机构信息未在 arXiv HTML 中可靠披露
- Araf Mahmud:机构信息未在 arXiv HTML 中可靠披露
- Sajib Hossain:机构信息未在 arXiv HTML 中可靠披露
- Tarikul Islam Tamiti:机构信息未在 arXiv HTML 中可靠披露
- Sajid Fardin Dipto:机构信息未在 arXiv HTML 中可靠披露
- Anomadarshi Barua:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
孟加拉语语音合成长期受限于小规模单说话人系统,最大先前平衡资源SUST仍为单说话人且只做音素/双音素覆盖,近期最优BnTTS在3.85k小时上微调XTTS但权重未公开,而已有开源零样本系统IndicF5克隆相似度仅0.37、微调YourTTS仅0.44,远低于人类水平。论文以连字簇为核心的分层Jensen-Shannon散度目标在音素、双音素、三音素和连字四层筛选脚本,筛选产出的脚本经质检与人工审核后进入录音室录制的Tier A与经信噪比和消融筛选的Tier B,合并为520.3小时、36说话人、7域的BanglaBox-520。合并一致性词表扩展保留704个预训练嵌入并过滤非法合并,将词表扩至4240,再经6步文本规范化处理连字簇、变音符号与数字缩写,产出可编码词元。词元与提示语音共同进入只训练变换器主体的提示掩码双损失微调,冻结说话人编码器并沿用预训练嵌入均值初始化以保留跨语言克隆能力,长文本按句切分后拼接合成。在5个留出说话人、76句、24名母语者ITU-T P.808评测下,BanglaBox自然度为4.56,以Wilcoxon符号秩检验显著高于Google的4.27和IndicF5的3.89。在436句测试集上以ECAPA-TDNN测得说话人编码器余弦相似度为0.627,近2倍于同设置下IndicF5的0.37,字错率为2.9%。结论适用于孟加拉国达卡标准语朗读文本,罕见三辅音连字、语码混合边界和拟声词仍不可靠,Chatterbox相关训练约100 H100小时、headline运行约28小时,含XTTS微调与推理总量约180 H100小时。
🔗 开源与复现资源
- 第三方资源:https://huggingface.co/Banglabox — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的语音合成问题是什么
论文处理的是孟加拉语文本转语音,也就是输入一段孟加拉语文字,输出对应朗读波形,同时要求保留目标说话人的音色。目标读者是刚进入语音或音频方向的研究生,可以把任务想象成 3 个必须同时满足的要求:读的内容要对,听起来要自然,声音要像给定的参考人。论文强调的难点在于孟加拉语属于低资源语言,已有语料多为单说话人小规模,缺少公开的零样本声音克隆系统。零样本在这里指合成时只给几秒未见过说话人的参考音频,不再为该说话人单独训练,就要模仿其音色朗读新句子。
论文选择以孟加拉国达卡地区的标准口音为对象,语料覆盖新闻、客服、教学、医疗、电商、金融和信息技术 7 个领域。评价既看可懂度和自然度,也看克隆相似度,并且要求在说话人不重叠的测试集上验证泛化。这种设置意味着模型不能靠记住训练说话人的音色拿高分,必须真正从短参考音频中抽取可迁移的音色表示,同时把孟加拉语特有的合字和尊称读准。
初学者如何理解输入输出与信息保留
举一个教学例子帮助复述,注意这只是例子而非论文数值:输入可以是一句含数字和尊称缩写的孟加拉语新闻句,加一段目标说话人的参考音频,输出应是同一句话由目标音色朗读的波形。信息保留要求内容词、数字读法、尊称全称和停顿位置正确,音色接近参考人。文本归一化负责把不可读符号变成可读词形,分词扩展负责把这些词形切成编号,T3 负责把编号映射成语音词元序列,说话人嵌入全程作为音色条件,声码器负责把词元变成波形。
若归一化缺失,数字会被猜读;若分词不一致,合字词会变未知标记;若掩码缺失,模型会复述参考音频的前段而不是朗读新文本。理解这条链路后,就能明白消融中为什么不同部件分别打击可懂度和相似度。初学者复述时可以沿着这条链路逐段检查:输入写法是否规范,切分编号是否合法,音色条件是否被真正使用,波形映射是否稳定。
已有孟加拉语和英语基础模型处在什么位置
论文把相关工作分成两条线。第一条是孟加拉语合成,已有隐马尔可夫模型、长短期记忆网络、VITS 和深度神经网络等尝试,但都受限于小而单说话人的语料,无法做跨说话人克隆和多领域覆盖。规模较大的平衡资源仍是单说话人,早期的均衡设计只考虑音素和二音素覆盖,没有对合字辅音丛库存建模。第二条是英语上表现较好的基础模型,包括编解码语言模型、潜在扩散和流匹配等家族,以及作为本工作起点的 Chatterbox。Chatterbox 是类 Llama 自回归变换器,自带用参考片段做零样本克隆的能力,但原文未在孟加拉语上验证。
论文还把商业系统和开放多语模型作为同场基线,例如谷歌、Azure、Narakeet、IndicF5、微调后的 YourTTS 和同语料微调的 XTTS-v2。作者明确指出,由于 BnTTS 权重未公开,无法与其做同编码器、同协议的直接对打,只能引用对方报告的数字作为指示性背景。这种谨慎划分比较条件的做法,是阅读本文结论时必须保留的前提。
跨语言适配必须保留什么、改变什么
把英语预训练模型搬到孟加拉语,输入处理和输出保真之间存在拉扯。必须改变的是文本侧:孟加拉语合字、与语境有关的元音符号和尊称缩写在标准工具链中缺失,数字和缩写若不展开会被错误朗读;分词器原本无法编码孟加拉文,直接导入合并规则会在含合字的词上产生未知标记。必须保留的是克隆能力:自回归解码器如果直接对提示音词元计算损失,会学会复制提示音的前一两秒,而不是利用说话人嵌入去控制音色,跨语言切换后克隆就会退化。
论文因此把问题定义为:在有限孟加拉语音频下补齐文本表示,同时冻结与音色空间和波形映射有关的部件,用掩码损失迫使模型依赖说话人条件。长文本还带来额外问题,单次生成超过约 850 个语音词元上限后容易提前结束或内容漂移,需要分块合成再拼接。容易误读的是把小时数对比当成胜负证明,原文明确小时数比只是事实属性,模型、编码器和协议都不同,不能直接推出优越。
两层语料加三步改造的总体流程
论文的总体流程是先建语料再改模型。语料分两层:A 层在达卡录音室新录,脚本由大模型按覆盖缺口生成并经过人工审核;B 层从公开孟加拉语数据中筛选保留高质量说话人。两层按分层散度目标合并成 520.3 小时、36 个说话人的语料,并划分出说话人不重叠的测试集。模型改造分 3 个阶段:扩展分词器、孟加拉语文本归一化、只训练 T3 的提示音掩码双损失微调。推理时对长段落做按句切分、每块独立合成、静音裁剪和固定停顿拼接,并使用更低的采样温度和更高的最小生成长度。
下图展示了语料两条支路如何汇合,是理解后文均衡目标和筛选代价的关键。
看图路径: 1. 沿上路看大模型生成脚本经过质量门和人工审核进入录音的流程;2. 沿下路看公开数据经过信噪比过滤和消融筛选保留说话人的分支;3. 看两路如何在底部汇成统一语料并标注说话人不重叠的测试划分
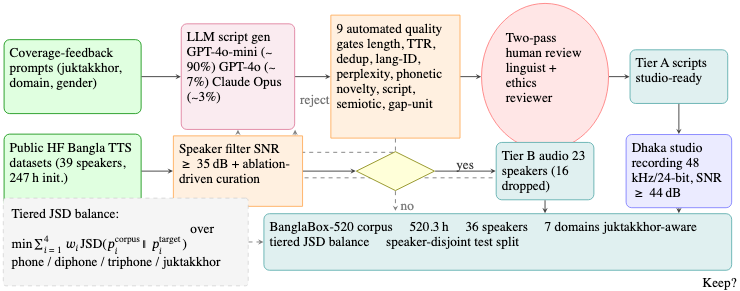
论文图 1。原论文 Figure 1::“Two-tier corpus construction (§2). Tier A passes 9 quality gates (thresholds: Table 21, App.”。
上图左侧绿色框是覆盖反馈提示,中间橙色框是大模型脚本生成与说话人筛选,右侧粉色椭圆是两遍人工审核,最下方是均衡目标与最终语料。上路不通过质量门会被拒绝重写,下路通不过信噪比和消融检查会被丢弃,图中标注丢弃部分初始说话人。阅读时注意箭头方向代表数据流向,而不是模型训练的梯度方向,底部公式对应后文分层均衡目标。
合字感知的分层散度如何挑选句子
juktakkhor 是论文反复强调的孟加拉语合字辅音丛,例如由多个辅音连写构成的音节块,其发音与组成字母的字面拼接不一致。分层 JSD 均衡中的 JSD 指 Jensen-Shannon 散度,用于比较两个分布的差异;分层指同时在音素、二音素、三音素和合字四层上分别比较已选脚本集分布与目标分布。目标分布是自然频率与均匀分布按 0.7 比 0.3 插值得到,均匀部分保证每个稀有合字都有非零目标,使优化无法通过忽略稀有单位而取胜。权重按 0.1、0.2、0.3、0.4 递增,越难用自然文本覆盖的层权重越大。
挑选过程是贪心的,每周根据当前未覆盖的合字重新提示大模型生成候选,经过 9 个自动门和人工审核后,只接纳能降低总损失的句子。论文报告 A 层最终达到音素 99% 以上、二音素 93% 以上、合字 85% 以上,常用前 150 个合字 97% 以上,这些是循环结束后的实测结果,不是预设的停止阈值。
juktakkhor × 分层 JSD 均衡: juktakkhor 指孟加拉语合字辅音丛,发音不能从组成字母直接拼出,是自然度的难点;分层 JSD 均衡指在音素、二音素、三音素和合字四层直方图上度量已选文本与目标分布差异并加权求和,juktakkhor 提供要补齐的稀有单位清单,分层 JSD 提供挑选句子的目标函数,组合后让语料在保持自然的同时覆盖稀有合字。
\[\mathcal{L}(S,T)=\!\!\sum_{k\in\{p,d,t,j\}}\!\!w_{k}\cdot\text{JSD}(P_{k},T_{k}),\]上式中 S 是已选脚本集,T 是目标,k 遍历四层,P 是已选集在该层的单位直方图,w 是该层权重。计算目标是让加权后的分布差异最小,原文用贪心接纳实现近似,没有给出闭式最优解。雷达图进一步显示四层差异随迭代收缩,其中合字轴收敛最慢,反映其在正字法中的稀疏性。
分词扩展、归一化和掩码损失如何分工
3 个改造分别处理输入编码、输入写法和训练监督。分词扩展把词表从 704 扩大到 4240,其中 1786 个是孟加拉语单元,并用合并且一致过滤器丢弃组成单元或合并结果缺失的合并规则,约 11% 的孟加拉侧导入规则被丢弃,避免推理时回退到未知标记。重设尺寸后的文本嵌入和输出头对重叠的 704 行直接复制,其余 3536 行用预训练行的质心均值初始化,以减少随机初始化带来的损失尖峰。
文本归一化是 6 步流水线,包括数字转换、冒号数字改写、数字转词、逐词统一码归一化、47 条宗教尊称缩写展开和按孟加拉语句号切分。提示音掩码双损失只训练 T3,冻结语音编码器和声码器,文本损失训练文本部分,语音损失只对提示音之后的位置求交叉熵。
下图显示只有 T3 可训练,以及前 75 个提示音词元被掩掉的含义,阅读时注意冻结与可训练符号的区别。
T3 × S3Gen: T3 是 Chatterbox 中负责由文本生成语音词元的自回归变换器,是唯一被微调的部件;S3Gen 是由语音词元重建波形的声码器部分,在本工作中保持冻结,T3 负责学好孟加拉语文本到词元的映射,S3Gen 负责稳定地把词元变成声音,组合后实现只动语言相关部分而不破坏已有音质映射。
文本归一化 × 合并且一致的分词扩展: 文本归一化指把数字、冒号数字、尊称缩写和标点切分转成可朗读的完整孟加拉语词形;合并且一致的分词扩展指把孟加拉语子词加入分词表时只保留组成单元和合并结果都在词表中的合并规则,前者解决输入写什么,后者解决输入如何被切成模型认识的编号,两者配合才能让归一化后的长词形被正确编码。
提示音掩码 × 说话人嵌入: 说话人嵌入指语音编码器从 3 到 10 秒参考音频提取的 256 维向量,代表目标音色;提示音掩码指训练时把前约 75 个语音词元位置从语音损失中排除,不让模型靠复制提示音词元降低损失,前者提供音色条件,后者迫使模型真正利用该条件,组合后保留跨语言的零样本克隆能力。
看图路径: 1. 找到只可训练的 T3 方框与冻结的语音编码器和声码器方框;2. 看文本归一化和分词扩展如何汇入 T3 的文本输入;3. 看提示音掩码分支如何把前段语音词元标为不计损失
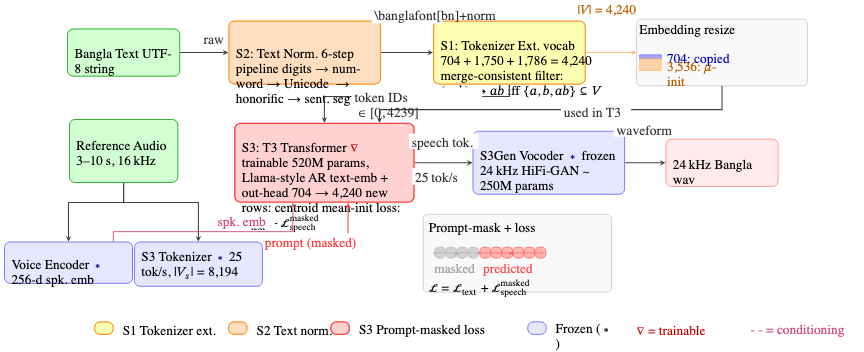
论文图 4。原论文 Figure 4::“BanglaBox architecture (§3.1). Only T3 is trainable (\nabla); the voice encoder and S3Gen vocoder stay frozen (\ast).”。
上图上方是文本侧从原始字符串经归一化和分词扩展进入 T3 的路径,下方是参考音频经语音编码器和语音分词器得到说话人嵌入与被掩码的提示音。图中标注嵌入扩大和新行均值初始化,以及损失等于文本损失加掩码后语音损失。虚线代表条件作用而非梯度流动,冻结部件不进入优化器。
\[\mathcal{L}=\mathcal{L}_{\text{text}}+\mathcal{L}_{\text{speech}}^{\text{masked}},\]\[\mathcal{L}_{\text{speech}}^{\text{masked}}=-\!\!\!\!\sum_{t=L_{\text{prompt}}+1}^{T}\!\!\!\!\log p_{\theta}(s_{t}\mid s_{\lt t},\mathbf{e}_{\text{spk}},\mathbf{c}_{\text{text}})\]前一式说明总损失是文本交叉熵与掩码后语音交叉熵之和,后一式说明语音损失从提示音长度之后的位置开始累加,条件包括冻结的说话人嵌入和归一化文本词元,提示音和右侧填充位置通过忽略索引不参与平均。
哪些参数被训练、代价和推理设置是什么
训练对象很明确:只更新约 520M 参数的 T3,语音编码器和 S3Gen 声码器全程冻结,不进入优化器参数集。优化器用 AdamW,峰值学习率 5 乘 10 的负 6 次方,余弦退火加 5% 热身,权重衰减 0.01,梯度裁剪到 1.0,全局批量 24 句,精度为 BF16,训练 30 到 50 轮。主运行约 28 小时完成 50 轮,消融多为 30 轮,8 个基于 Chatterbox 的运行共约 100 个 H100 小时,另有同语料 XTTS-v2 微调约 75 小时,总训练约 175 小时,推理评估约 4.5 小时。
长文本推理不是一次生成整段,而是按孟加拉语句号切分后逐块合成,用语音活动检测裁掉块尾静音,再以 200 毫秒零填充拼接,以还原句号处的韵律重置。推理采用针对孟加拉语校准的超参数,例如温度从英语默认 0.8 降到 0.3 以抑制在陌生合字上幻觉出英语音素,最小新语音词元数提高到 150 以减少短参考下的提前结束。分块带来吞吐代价,但在大段落上是唯一可用的稳定方案。
评测在什么数据、指标和统计下进行
评测协议名为 BanglaEval,测试集是说话人不重叠的 5 个保留说话人约 76 小时。客观部分用 436 句领域分层子集,字符错误率用强制为孟加拉语的 Whisper large-v3 计算,音质用 NISQA 参考无关估计,说话人相似度用 192 维 ECAPA-TDNN 向量的余弦相似度即 SECS。主观部分用 76 句领域均衡集,24 名来自孟加拉国的母语人按国际电信联盟 P.808 要求佩戴封闭式头戴耳机、在响度归一化条件下,对自然度、说话人相似度主观分和清晰度分别打 5 分制,每个系统每维度 1824 条评分。质量控制每场插入两类捕捉试验,不通过者剔除并由备选评分者重评。统计用配对 Wilcoxon 符号秩检验加 Bonferroni 校正,主观三指标对 5 个基线比较,SECS 对 3 个可克隆基线比较。
CER × SECS: CER 指用孟加拉语强制的 Whisper large-v3 转写合成音频后再算的字符错误率,反映可懂度,越低越好;SECS 指用 ECAPA-TDNN 提取合成音频与参考音频说话人向量的余弦相似度,反映音色接近程度,越高越好,两者分别回答读得对不对和听起来像不像,需要同时看。
下图是评测管线的读图导引,重点看清客观与主观分支的样本量不同,以及商业系统无说话人自适应的处理。
看图路径: 1. 从左侧说话人不重叠测试集出发,数清参与比较的系统分支;2. 区分客观分支的 436 句与主观分支的 76 句加 24 人评测;3. 注意 XTTS-v2 只计客观和克隆指标的标注
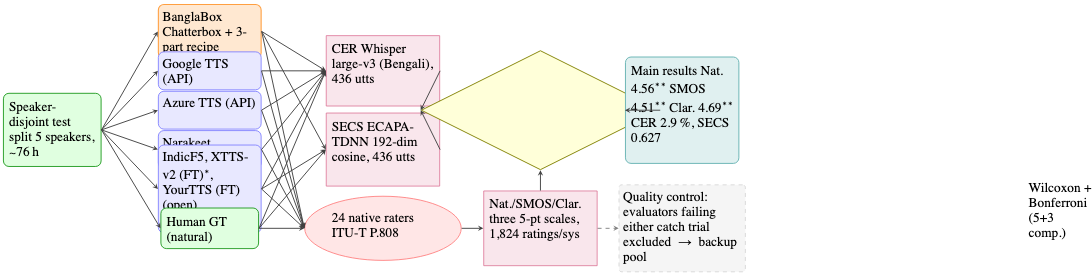
论文图 5。原论文 Figure 5::“BanglaEval evaluation pipeline (§4). ∗XTTS-v2 (FT) is scored on objective and cloning metrics only.”。
上图左侧是同一测试集分发到各系统,中间粉色框是客观指标计算,红色椭圆是人工评测,右侧蓝色框是论文报告的主结果数字。菱形代表汇合比较,灰色框是质量控制说明。图中标注的人类自然录音是上限参考,不是参赛系统,XTTS-v2 仅计客观和克隆指标。
主结果在什么条件下成立、规模效应如何
在上述说话人不重叠测试和配对统计下,BanglaBox 在自然度、说话人相似度主观分和清晰度上同时领先 5 个基线,且每对差异在校正后显著。论文给出自然度 4.56,距离人类上限 4.76 约 0.2 分;客观上字符错误率 2.9%,接近谷歌的 2.2% 并优于开放基线;SECS 为 0.627,明显高于同场可克隆基线。10 秒参考下克隆领先保持,5 秒参考下仍领先但绝对值下降。按领域拆分时自然度在 7 个领域内保持在窄带,没有某个领域被均衡语料落下。
下图显示从 100 小时到 520 小时自然度持续提升,而字符错误率在 200 小时后趋于饱和,说明继续加数据对可懂度的边际收益变小。
看图路径: 1. 看横轴 100 到 520 小时三档语料规模;2. 对比左侧自然度曲线继续上扬与右侧字符错误率趋平的走向;3. 确认星号标记的全量配置位置
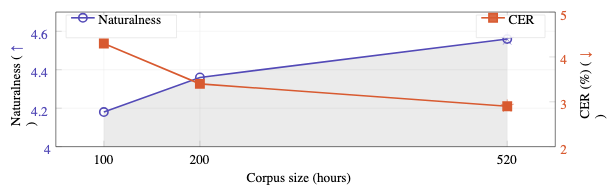
论文图 6。原论文 Figure 6::“Data scaling on 100/200/520 h subsets.”。
上图横轴是语料小时数,左侧纵轴是自然度越高越好,右侧纵轴是字符错误率越低越好。紫色自然度线从 100 小时向 520 小时上扬,橙色错误率线在 200 小时后变平。灰色阴影只是辅助阅读,不是置信带,星号代表全量配置。这一形态支持论文重质不重量、均衡优先的主张,但只在本文的划分和指标下成立。
下面这张原表把比较从自家划分搬到公开评测集,是主结果之外的重要泛化证据,问题是公开集上字符错误率能否复现优势。
| Benchmark | BnTTS CER | Our CER | Our SECS |
|---|---|---|---|
| BengaliStimuli53 | 8.6% | 7.2% | .78 |
| BengaliNamedEntity1000 | 4.0% | 2.9% | .68 |
| ShortText | 9.2% | 6.7% | .51 |
上表三行分别对应不同公开子集,每行同时给出对方报告的字符错误率、本方法在该集上的字符错误率和说话人相似度。数字越小代表转写错误越少,相似度越大代表音色越接近。由于权重未公开,这仍是同协议下的客观重测而非同编码器对打,行间样本量不同也不能跨行直接比绝对值。
下面这张整理表回答相对提升的幅度问题,比较对象是商业与开放基线,指标方向是自然度越高越好、相似度越高越好。
| 比较对象 | 指标方向 | 自然度相对提升 | 克隆相似度 | 适用限制 |
|---|---|---|---|---|
| 谷歌 | 越高越好 | +6.8% | 商业系统无自适应 | 仅比自然度 |
| IndicF5 | 越高越好 | +17.2% | 0.37 | 同场可克隆基线 |
| 本方法 | 越高越好 | 领先 | 0.627 | 需短参考音频 |
| 评价条件 | 配对检验 | 校正后显著 | 余弦相似度 | 编码器与协议相关 |
| 推广边界 | 域内测试 | 窄带稳定 | 长句可能漂移 | 跨域需重测 |
上表显示自然度相对提升与克隆相似度接近翻倍同时出现,但代价是结论依赖特定的说话人编码器和评测协议。商业系统不参与相似度比较,开放基线的相似度远低于本方法,反例是长句韵律仍会漂移,因此不能把单点优势推广为所有文本类型。
拿掉每个部件会发生什么、均衡是否独立起作用
消融回答每个改造是否必要。去掉文本归一化带来最大的字符错误率和自然度下降,说明数字与尊称展开对可懂度最关键;去掉提示音掩码带来最大的 SECS 下降,且对照检查点出现逐字复述提示音前一两秒的现象,证实掩码是克隆保真度的决定性部件;回退到朴素分词扩展则三项指标全面变差;解冻语音编码器变化很小。为分离数据量与分布的作用,论文在相同 100 小时下比较均衡挑选与随机挑选,结果是错误率大幅下降而覆盖率差异解释了机制,3 种子重跑后均衡侧自然度均值更高。
下面这张整理表直接检验分布而非时长的作用,问题是相同时长下均衡挑选是否改变学到的内容。
| 挑选方式 | 自然度 | 字符错误率 | 说话人相似度 | 稀有合字覆盖 | 训练条件 |
|---|---|---|---|---|---|
| 分层散度均衡 | 4.18 | 4.3% | 0.54 | 91.7% | 相同 100 小时 |
| 随机挑选 | 4.21 | 7.1% | 0.52 | 79.8% | 相同 100 小时 |
| 相对变化 | 基本持平 | 下降约 39% | 略升 | 覆盖更高 | 单次运行 |
| 3 种子均值 | 4.31 | 未报告 | 未报告 | 未报告 | 需结合随机性 |
| 限制 | 区间重叠 | 需重跑确认 | 幅度小 | 长尾仍弱 | 不根除失败 |
上表显示自然度在单次运行中区间重叠、无法区分,但错误率相对下降约 39%,覆盖率差异解释了机制:随机子集漏掉更多稀有合字。限制是单次运行混杂训练随机性,需要结合 3 种子均值才能谈自然度差异,反例是三辅音稀有合字仍不可靠。
下面这张整理表说明哪个部件对应哪类错误,问题是掩码缺失的失败形态是什么。
| 条件 | 训练步数 | SECS | 主观相似度 | 失败现象 | 结论 |
|---|---|---|---|---|---|
| 完整方法 | 全量 | 0.627 | 4.51 | 正常朗读新文本 | 掩码有效 |
| 观察窗口 | 1500 步起 | 下降 | 下降 | 跨说话人可见 | 非偶发 |
| 冻结编码器 | 全量 | 基本不变 | 基本不变 | 无明显变化 | 安全默认 |
| 未解问题 | 长尾 | 稀有合字弱 | 边界伪影 | 拟声词不稳 | 待改进 |
上表未列出未胜出项之外的精确显著性层级,完整 p 值见原文附录。反例是三辅音稀有合字、语码切换边界和拟声词仍不可靠,说明均衡改善了覆盖但未根除长尾发音问题,解冻编码器也不是提升方向。
哪些结论不能推广、还有什么失败模式
论文用专门章节承认边界。首先是说话人规模 36 人小于常用多说话人库,克隆泛化可能受限;其次 A 层与 B 层录制条件和来源不同,B 层已淘汰 16 人但残留差异仍可能存在。其次是 A 层脚本全部由大模型生成,尽管经过困惑度、语言识别和两遍人工审核,仍可能带有翻译腔,好在自然 B 层文本上的错误率基本不变,说明自家结果未被模型文体大幅抬高。再次是与 BnTTS 的小时数比只是两套训练配置的事实属性,由于编码器、模型家族和评测协议不同,不能当作同条件优越性证明。
失败模式包括出现率低于 0.3% 的三辅音合字偶发卡顿或加元音、孟加拉语英语混读边界出现短静音和音高重置、训练不足 5 次的拟声词输出不稳定。长句韵律也被直接测量,基频误差和时长偏离随长度增大,时长偏离约翻倍,说明离参考越长越容易漂。主观置信区间重叠不等于不显著,因为区间是边缘分布而检验是配对的;NISQA 只作辅助指标,因其训练以英语德语为主。
复现第一步做什么、需要哪些材料和检查
复现应从数据和文本处理开始,而不是直接调模型。第一步是按论文的划分复刻说话人不重叠的训练、验证和测试集,并确认测试说话人未在训练中出现;同时跑通 6 步归一化脚本,重点检查数字转词和 47 条尊称展开是否与原文词典一致。第二步是复刻合并且一致的分词扩展,验证 704 行复制、3536 行质心初始化以及非法合并被丢弃的比例。第 3 步才是只训练 T3 并冻结另两部分,用忽略索引同时屏蔽提示音位置和右侧填充。硬件上至少准备单卡 80 GB 级别环境,主运行需要数十小时。
评估时客观用同样版本的转写和说话人编码配置,主观需招募孟加拉国母语人并执行捕捉试验和配对统计。资源方面,论文给出的地址当前可达,但可达只代表链接能打开,不等于已确认代码、权重或完整系统可用;第三方托管的作者归属尚未确认,具体包含语料、权重、适配器、分词扩展、归一化脚本、训练推理代码和逐条评分记录等哪些内容,应以资源页面文档所列为准,尚无法确认的完整可用性不要默认成立。
什么时候值得尝试、还缺哪项验证
当任务是为低资源语言适配英语自回归语音基础模型,且合字或特殊缩写导致可懂度问题时,这套先均衡语料再做 3 步改造的路线值得尝试;当只有几秒参考音频且要求保留音色时,提示音掩码和冻结编码器的组合是关键。预期收益是有证据的:在本研究的测试、压力集和公开子集条件下,自然度、清晰度和克隆相似度同步改善,且数据效率高于大音量基线配置。主要代价是录音室录制、人工审核和筛选计算,以及长文本必须分块带来的吞吐下降。
还缺的验证包括更大说话人多样性下的克隆泛化、孟加拉国以外变体的测试、流式推理的延迟测量,以及与未公开权重系统的同编码器对打。在补齐这些之前,不宜把指示性小时数对比或自动指标排名推广为普遍优越性判断。关键超参数如 0.1 到 0.4 的权重、0.7 的插值、75 个掩码位置、0.3 温度和 200 毫秒拼接停顿,复现时应保持一致并报告测量条件。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses