英文题目:VoxReason: Listener-Free Evaluation of Source-Grounded Speech Planning Before Synthesis
标签:#语音合成 | #SFT | #基准测试 | #模型评估
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
👥 作者与机构
- Mengzhe Geng:National Research Council Canada
📌 核心摘要
论文把合成前 delivery 决策做成带源引用的结构化说话计划,用确定性校验器检查引用合法性与单线索局部性,在 32 种子 100 例 full100 对照中去掉源记录使引用必需分数下降 0.488,而 7B 局部性修复在源键留出下恢复槽位准确率与局部性。
🔗 开源与复现资源
- 代码相关资源:https://github.com/MENGZHEGENG/voxreason — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
合成前到底在决定什么,为什么听感好还不够?
输入是固定的目标句子、对话上下文、角色与场景信息,以及许可的源标签线索;想改变的是把 delivery 从波形里的隐式风格变成合成前显式的结构化决策;必须保留的是每条 delivery 取值都能回溯到用例内存在的源记录;输出是一个带证据引用的说话计划,而不是音频本身。
论文反复强调的失败发生在波形存在之前:系统可能语气听起来合理,但所选的白话讲就是说话方式,包括 affect(情感态度)、pitch(音高)、energy(能量)、rate(语速)、pause(停顿)、emphasis(重读)与 stance(立场),并非来自源记录,而是来自背住的社会脚本。下游音频评分很难暴露这种源使用失败,因为评分只看到最终声音,看不到选择依据。教学示例是同一句 Kids are talking by the door,在 happy 源线索下应取高能量与上扬音高,在 sad 下应取低能量与长停顿,文本完全相同,差别只应来自引用的源标签。
因此论文把任务限定为无听众评估:不渲染波形,不做偏好判断,只检查计划 JSON 与引用是否合法。这种收窄不是省略音频,而是先把因果链条固定下来。如果这一步对不上记录,后续再好听的合成也没有可信的评估对象。渲染波形质量明确在本次评估之外。
已有上下文 TTS 与语音推理工作缺了哪一环?
先说输入与对象是否相同。上下文感知 TTS、语音角色扮演与语音推理基准同样接收文本之外的上下文,有的还带有时间戳证据或韵律条件动作,目标多是让最终语音更贴合场景。VoxReason 与它们接收的上下文类型有重叠,但改变的对象不同:它不直接优化波形,而是把句子到 delivery 的中间决策单独拿出来作为一等预测。
再看监督与运行阶段是否相同。过程奖励工作把中间推理轨迹当作可度量对象,而多数音频推理与奖励模型评估仍对最终答案、波形或打分结果计分。VoxReason 的监督位置更靠前:只有当模型说出允许的源记录、记录内容匹配、且许可线索变化时局部跟随,才给 delivery 字段记分。比较时不能把不同阶段的分数直接换算成胜负。
论文的位置因此是补一个测量层,而不是替换合成器。它固定了校验器与端点层级,让引用格式、自由文本证据、转录文本对照等不同前端可以在同一用例与解码设置下比较。原文也明确指出,等价文本证据在某一聚合对照上与类型化引用相当,所以真正固定的是校验器,不是某种提示配方。
什么才算真用了源记录,论文如何把它变成可证伪的断言?
论文的可证伪断言只有一条:说话规划器只在被引用的源线索许可时才改变 delivery 字段。即使解释写得流畅,只要靠记忆源情感与强度键、复制词汇先验,或在单线索编辑后连带改动无关槽位,都算违背该断言。这个定义把风格好坏问题转换成记录许可问题。
为此每个用例被设计成最小对:文本与大部分上下文固定,只改变许可的源标签。例如同一句话在 happy 与 sad 下分别许可不同的 pitch、energy、pause 与 stance,neutral 编辑则规定哪些槽位应回落、哪些必须保持稳定。共享用例编号与解码设置让转录文本、源标签与扰动变体之间的失败可归因于源使用,而非评估漂移。
判定标准也事先固定:主要端点是引用必需 grounded 分数,其次按证据 F1、计划槽位准确率、非门控 grounded 分数与幻觉证据率的 Holm 顺序读取。引用标识不是装饰,删除、交换或编造都会导致拒绝。普通槽位准确率被明确视为必要但不充分,必须先过引用合法性与局部性检查。
从用例记录到可检查分数,系统走完哪几步?
规划器先接收对话上下文文本、可用的许可声学特征、角色元数据与目标话语,然后返回受约束的 JSON,其中包含证据引用与 emotion、intent、pitch、energy、rate、pause、emphasis、stance 等说话计划槽位。渲染器即使存在,也位于该预测下游,本次评估不进入波形分支。
源记录 × 说话计划: 源记录指用例内允许被引用的对话文本、角色、场景与源标签线索,说话计划指对 emotion、intent、pitch、energy、rate、pause、emphasis 和 stance 的结构化取值;前者负责提供合法依据,后者负责给出可检查的 delivery 结论,二者搭配的原因是把藏在波形里的风格选择提前为可审计对象,组合后新增的含义是每个被接受的 delivery 字段都必须能回溯到一条存在的记录。
校验器接着沿引用回查用例记录,依次确认引用源存在、槽位取值与源标签一致、不存在无支持的状态、单线索编辑只改变应变的槽位。指标层继承该定义:证据 F1 管引用检索,槽位准确率管 delivery 一致,grounded 分数合并二者并惩罚无支持引用,引用必需变体在缺必需引用时将标量清零,反事实一致性再检验局部改动是否正确。反事实一致性的计算是预期变化准确率乘以一减非预期变化率,奖励动对地方且不动无关槽位。
方法总览的主路径是规划器预测带引用的槽位,校验器检查源合法性与槽位一致,单线索编辑检验局部性,下方证据记录汇总校验结果,虚线波形分支明确排除在当前断言之外。理解时应先走输入到输出的主箭头,再看编辑分支如何回接到槽位稳定性判断。
说话计划与确定性校验器各自检查什么?
说话计划是预测对象,它的每个槽位都有类型约束,emphasis 还要求集合一致性。下面这张最小对表要回答的具体比较问题是:在文本、角色 actor 04 与场景 acted emotional prompt 都固定时,不同源标签分别许可哪些 delivery 取值,以及 neutral 编辑后应如何回落。统一条件固定了词汇与范围线索,指标方向是槽位取值必须与许可标签一致。
| Source label | Licensed delivery fields | Static scope cues | Neutral edit | Verifier point |
|---|---|---|---|---|
| happy | emotion happy; intent encourage; emphasis happy; energy high; pause short; pitch raised; rate medium; stance positive | role actor 04; scene acted emotional prompt | emotion neutral; intent inform; emphasis neutral; energy medium; pitch neutral; stance neutral | A neutral plan loses the positive stance and raised pitch licensed by the cue. |
| sad | emotion sad; intent console; emphasis sad; energy low; pause long; pitch lowered; rate slow; stance vulnerable | role actor 04; scene acted emotional prompt | emotion neutral; intent inform; emphasis neutral; energy medium; pause short; pitch neutral; rate medium; stance neutral | A lexical-only plan misses the lower energy and longer pause licensed by the cue. |
| angry | emotion angry; intent confront; emphasis angry; energy high; pause short; pitch raised; rate fast; stance assertive | role actor 04; scene acted emotional prompt | emotion neutral; intent inform; emphasis neutral; energy medium; pitch neutral; rate medium; stance neutral | A generic social script moves unrelated slots after the local edit. |
表中 happy 许可鼓励类意图、高能量、短停顿、上扬音高与积极 stance,sad 许可安慰类意图、低能量、长停顿、下调音高与脆弱 stance,angry 许可对抗类意图、快语速与果断 stance。neutral 编辑把情感相关槽位拉回中性或 medium 设置,但要求无关字段稳定。这张表不支持任何模型排序结论,它只定义什么变化是合法的。
证据 F1 × 计划槽位准确率: 证据 F1 负责衡量引用的源记录是否找对找全,计划槽位准确率负责衡量 delivery 取值是否与源标签许可一致;前者只管引用通道,后者只管取值通道,论文把二者搭配是因为只对一半仍可能作弊,组合后 grounded 分数与引用必需分数要求引用与取值同时通过,新增的含义是漏引或错引不能再靠猜对槽位拿分。
校验器的动作比计划更细,它要拒绝多类捷径。下表要回答的比较问题是:每种引用与取值失败分别映射到哪个独立指标。统一条件是同一用例记录与严格模式 JSON,指标方向是引用缺失、取值错误、编造状态、编辑后漂移各自计分,互不替代。
| Trace | Licensed cue | Verifier-accepted change | Shortcut that fails |
|---|---|---|---|
| Happy source cue | context audio names happy source metadata for the fixed utterance. | Raise pitch, high energy, short pause, positive stance, and encourage-like intent. | A dialogue-only citation cannot license the affect-linked delivery slots. |
| Sad source cue | context audio names sad source metadata while text and role remain fixed. | Lower pitch, low energy, long pause, slow rate, and vulnerable stance. | A lexical prior that keeps the happy delivery loses slot agreement after the cue flip. |
| Angry source cue | context audio names angry source metadata with the same sentence template. | Fast rate, high energy, raised pitch, short pause, and assertive stance. | Broad drift in unchanged role or scene fields is counted separately from correct emotion movement. |
| Neutral edit | The edited source cue removes the affect label while dialogue, role, and scene stay unchanged. | Emotion-linked slots return to neutral or medium settings; unrelated fields stay stable. | A memorized source-key plan fails locality if it keeps affective slots or changes unrelated fields. |
从轨迹看,happy 要求上扬音高与鼓励意图,对话单独引用不能许可情感相关槽位;sad 要求下调音高与长停顿,保留 happy 交付的词汇先验会在翻转后失去槽位一致;angry 要求快语速与果断 stance,但角色或场景漂移要另计;neutral 编辑要求记忆源键的计划在保留情感槽位或改动无关字段时判为局部性失败。阅读任何分数前要先看覆盖率与严格模式有效性,只有完整种子用例覆盖且 JSON 严格有效的输出才能进入比较。
单线索编辑如何区分跟随记录与背模板?
单线索编辑的执行顺序值得跟着一个样本走一遍。以 happy 用例为例,原始引用指向 happy 源元数据,计划取高能量与积极 stance;编辑把源线索换成 neutral,对话、角色与场景保持不变;期望行为是情感相关槽位回落到 neutral 或 medium,无关字段保持稳定;校验器分别统计预期变化准确率与非预期变化率,再以前者乘以一减后者得到反事实一致性,而不是两者直接相乘。
下表要回答的比较问题是:校验器的 6 条不变量如何把引用不存在、取值错误、缺必需引用、编造状态、编辑后大面积改写、前后端漂移分开计数。统一条件是确定性校验器在合成前运行,指标方向是每条不变量对应一个独立报告指标,引用必需分数为主要端点。
| Check | Invariant | Failure caught | Reported metric |
|---|---|---|---|
| Cue support | Each cited cue appears in the case record | Cites an absent speech, role, or scene cue | Evidence precision/recall |
| Slot grounding | Cue-linked slots match source labels | Uses a real cue but assigns the wrong plan value | Plan-slot accuracy |
| Required citation endpoint | The primary score requires legal cited cues and source-label slot agreement | Rewards a correct plan despite missing or wrong source records | Citation-required grounded score |
| No invented state | Scene and speaker facts come from allowed sources | Adds unsupported social or acoustic state | Unsupported-evidence rate |
| Local edit response | Only edited-cue slots move under counterfactuals | Rewrites unrelated slots after a local cue edit | Counterfactual consistency |
| Front-end stability | Case IDs and decoding stay fixed across front ends | Confounds representation effects with prompt or case drift | Grounded score by front end |
表后需要强调两个边界。第一,文本证据对照在 PromptClean 聚合上并不弱于类型化引用,因此校验器测的是记录使用,而不是某种引用格式天然优越。第二,源情感先验在编辑用例指标上可能取高分,但它没有引用通道,不能与源引用规划准确率混为一谈,分裂设置下应把局部响应与引用规划分开解读。
引用必需 grounded 分数 × 反事实一致性: 引用必需 grounded 分数负责在当前用例上做静态对账,缺必需引用时将标量清零,反事实一致性负责在单线索编辑后做动态对账,要求预期变化准确且非预期变化率低;前者防省略关键证据,后者防大面积改写,二者搭配后系统既要这次引对,又要在源记录变化时改对地方,组合后多解决的是把记忆模板与真正跟随记录的行为区分开。
学习配置更新了什么,公式里的三项奖励各管哪段信号?
论文的学习目标把有监督计划似然与过程奖励写在一起,作为评分目标与可报告端点的定义式。符号对应关系是:theta 为规划器参数,hat E 与 E 分别为预测引用与金引用,hat y 与 y 分别为预测计划与金计划,hat y cf 为编辑后的预测计划;lambda 系数只平衡三项奖励的权重。
\[\mathcal{L}(\theta)=\mathcal{L}_{\mathrm{sft}}(\theta)-\lambda_{E}R_{E}(\hat{E},E)-\lambda_{Y}R_{Y}(\hat{y},y)-\lambda_{C}R_{C}(\hat{y},\hat{y}^{\mathrm{cf}}),\]公式的计算含义是:L sft 约束模式对齐的计划似然,R E 奖励证据精度与召回,R Y 奖励槽位级计划一致,R C 奖励局部反事实一致性。该式定义要拉近什么与惩罚什么,不代表梯度直接穿过 3 个离散校验器回传。已学习配置的真实实现是通过模式对齐的有监督微调实例化该目标,偏好配置再用成对 DPO 更新加以补充,具体配方与复用初始化汇总在原文表 31。
需要区分训练与部署阶段。训练阶段更新的是 Qwen2.5 系列指令模型的规划器参数,输入包含源记录;部署与评估阶段参数冻结,给定新用例记录输出 JSON,再由确定性校验器计分。结构化输出应力测试显示,初始模式加 DPO 设置在 54 个跟踪输出中有 25 个失败,多为不可解析 JSON,而低学习率修复与模式对齐运行在其跟踪输出上严格有效,这些配置只测接口有效性,不进入最终模型排序。
数据从哪里来,划分与指标如何固定以防泄漏?
源标签研究使用 1440 条 RAVDESS 记录,需依次通过源解析、元数据映射、计划重建、线索检查、反事实标签、置信策略、许可字段、泄漏检查与分裂完整性后才进入分析;另有 108 例确定性 bootstrap 分裂只校准模式与评估器,不用于经验断言;学习到的 full100 比较保留早期固定的 100 例协议以保证模型间可比,该 100 例是后文 0.488 效应的实验身份;1800 个 CREMA-D 片段只做跨语料库导入检查,因场景标签有限反而收紧而非放宽主结论。源键不交叠划分另取 60 训练、16 开发、24 测试且零源键重叠。
现在看覆盖图的原因是:必须先确认校验规则作用于完整分裂与标签覆盖,而非几个手选例子。该图 4 个面板分别为情感、强度、划分与语句分布,下方注记强调计数是确定性用例记录标签,而非感知验证。
看图路径: 1. 先看左上 Emotion 面板,确认 neutral 为 96、其余多为 192;2. 再看右上 Intensity 面板 normal 为 768、strong 为 672;3. 最后核对左下 Split train 960、dev 240、test 240 与右下 Statement 各 720
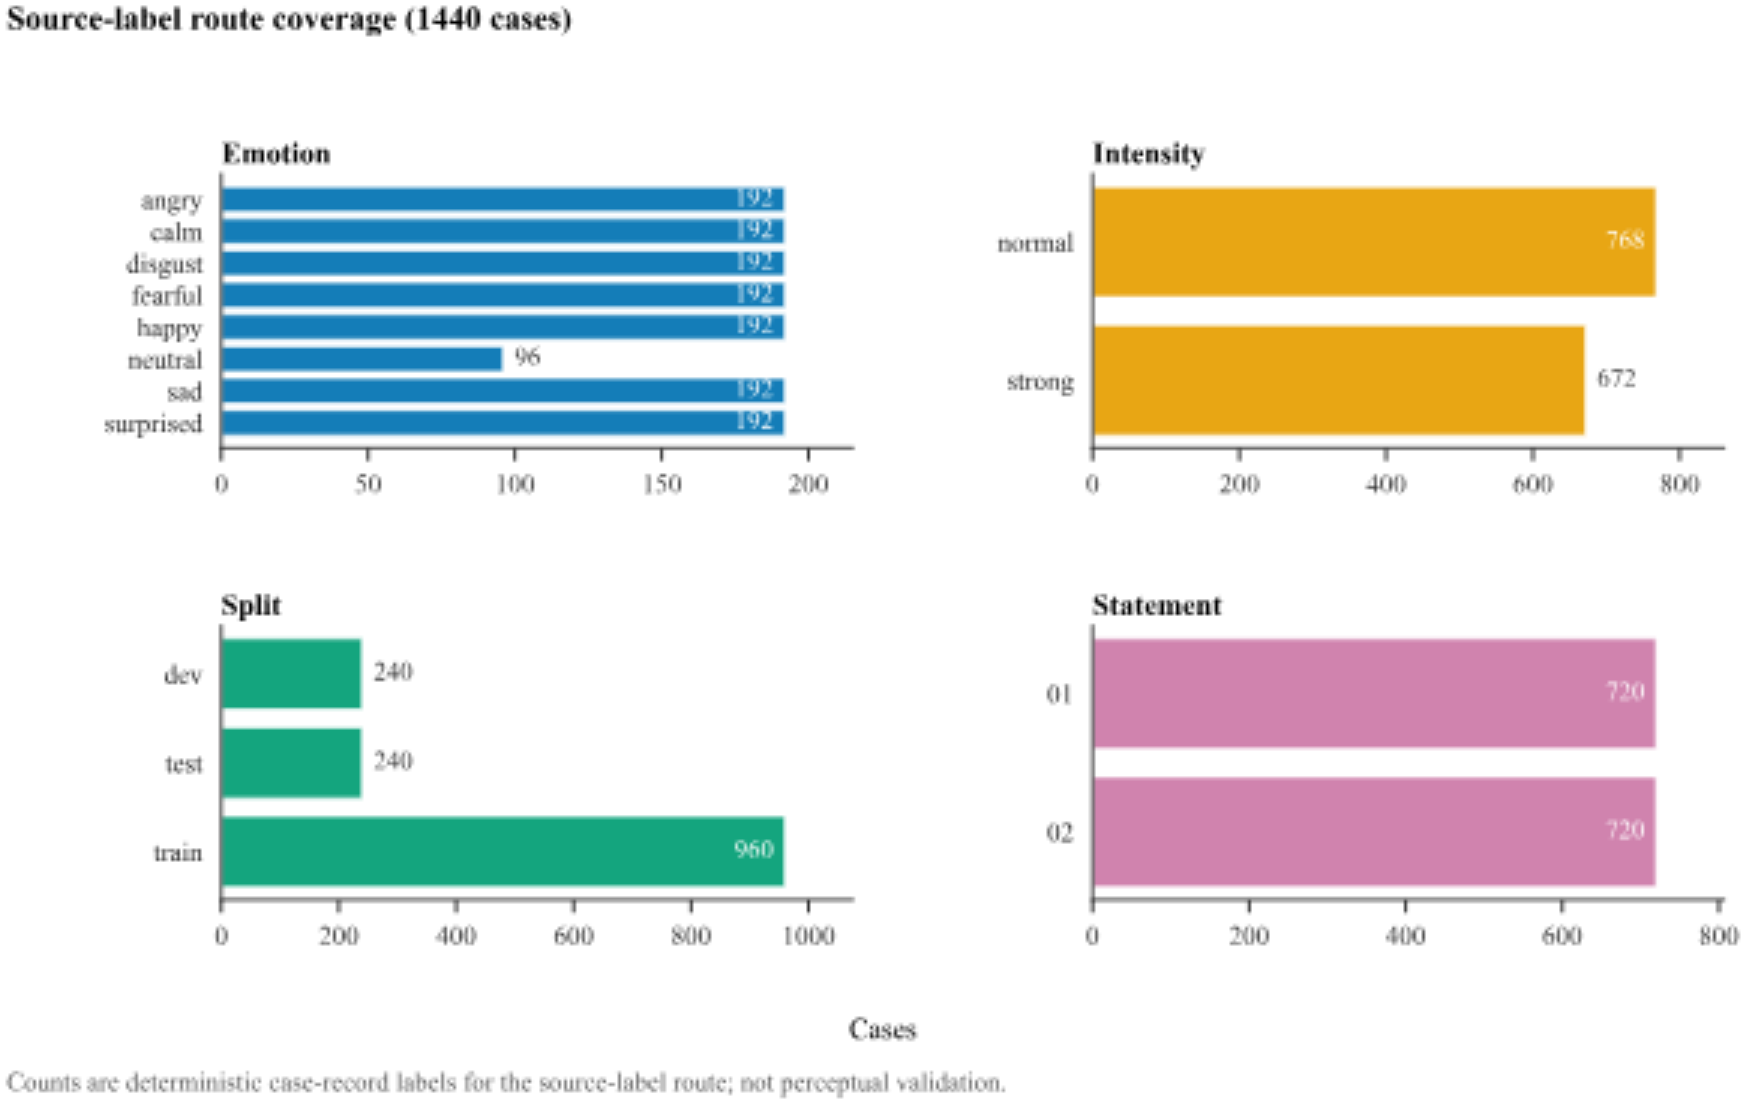
论文图 2。原论文 Figure 2::“Source-label distribution for the 1,440-case listener-free setting.”。
图中可见情感面板除 neutral 为 96 外其余多为 192,强度面板 normal 为 768、strong 为 672,划分面板 train 为 960、dev 与 test 各为 240,语句 01 与 02 各为 720。这种窄分布正是实验干预:只保留两种目标文本、24 个角色与 1 个场景标签,使文本、角色与场景变化最小化,从而把检验力集中到源记录到 delivery 字段的链路上。代价是公开上下文音频为零,每 15 个情感强度键确定性映射到单一金计划,广义的文本与场景泛化断言在此不能成立。
指标方向事先固定:证据 F1、槽位准确率、引用必需分数越高越好,幻觉证据率与未引用率越低越好,覆盖率要求完整种子用例覆盖与严格模式有效。统计上共享用例时用配对自助区间,种子级表用跨种子标准差,正负号默认表示跨种子标准差,除非明确写出配对置信区间。
源访问带来的增益有多大,是否超过模型规模效应?
核心比较问题是:在同一 7B 家族与解码设置下,加入源标签相对只看转录文本,能否在引用必需分数与槽位准确率上带来稳定增益。统一条件是 32 种子、100 个源标签用例的 full100 对照、完整覆盖与严格模式有效,指标方向是引用必需分数为主要标量,证据 F1 与槽位准确率为次序固定的辅助端点。该实验身份必须保留:下述 0.488 与 0.599 增量来自该 full100 对照,不是 1440 条重建记录。
下图快照直接服务该比较,但其自身身份不同:它是 32 种子、16 个留出测试用例的覆盖快照,不是 full100。横轴为 0-1 公共轴,点位为三项指标均值,横向区间为跨种子标准差。阅读时不要把该排序当作最终模型比较结论,原文明确其只是覆盖快照,也不要直接用图点相减代替 full100 配对增量。
看图路径: 1. 先沿横轴 0-1 比较三行配置的蓝色 Evidence F1 点位;2. 再看黄色 Plan acc 与绿色 Citation req 在 transcript-only 行的左移;3. 最后核对每行 32/32 seeds 横向区间为跨种子标准差而非配对置信区间
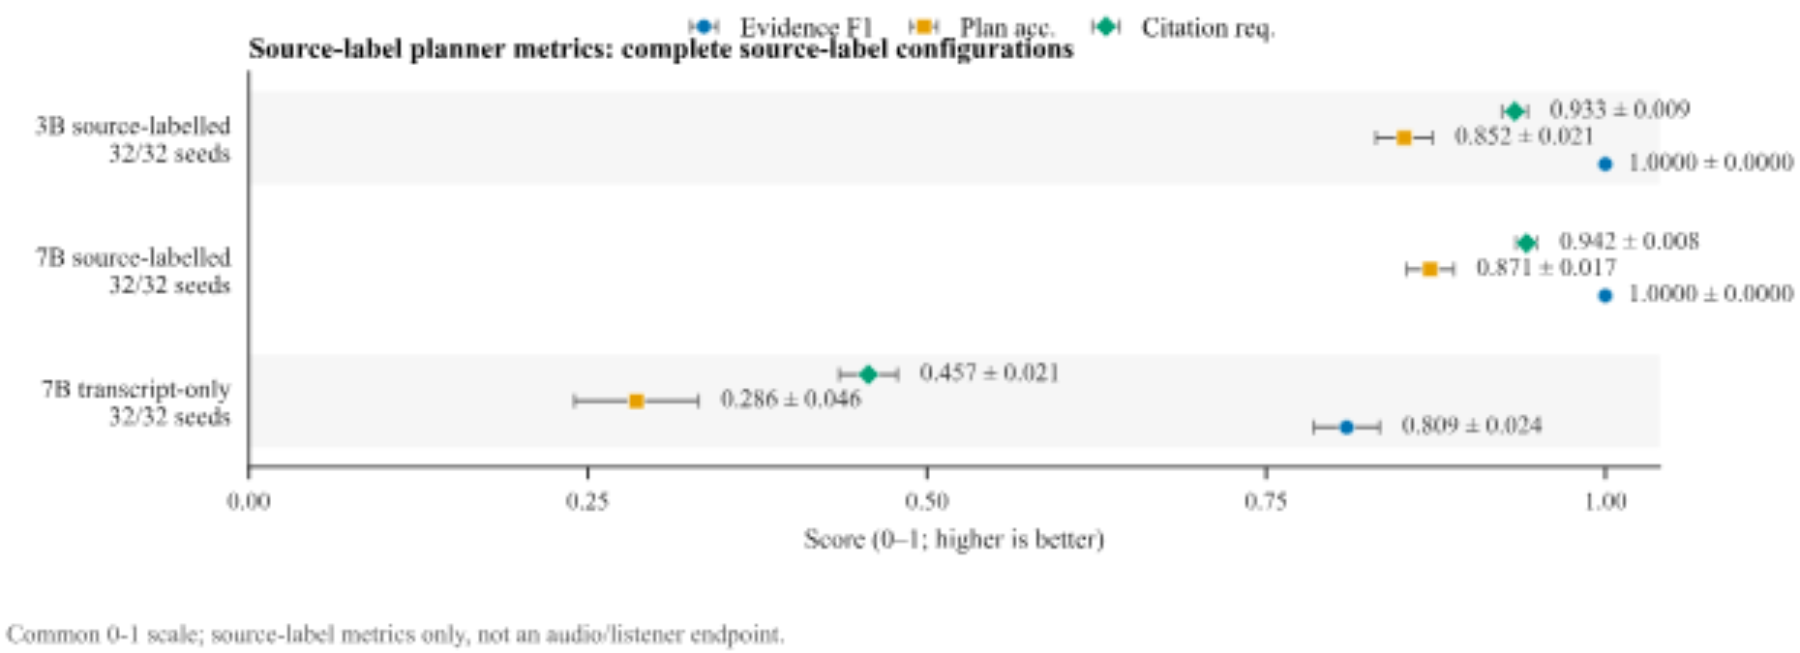
论文图 3。原论文 Figure 3::“No-listener coverage snapshot for source-label learned-planner configurations over 32 seeds and 16 held-out source-label test cases.”。
图中 7B 源标签配置的证据 F1 约为 1.0000,计划准确率约 0.871,引用必需分数约 0.942,而 7B 转录文本对照的对应三项分别约为 0.809、0.286 与 0.457。这些图点属于 16 例快照。配对增量在 32 种子 100 例 full100 对照中报告为源通道使引用必需分数提高 0.488、95% 区间为 0.483 到 0.492,计划槽位准确率提高 0.599、无支持证据降低 0.139;同 full100 设置下的模型规模对照仅为 0.023 与 0.051。原文进一步报告源通道下限超过规模对照上限,且在最终区间重采样、稳健性检查与替代权重下保持稳定。
转录文本对照 × 源标签上限: 转录文本对照指去掉声学与角色等源线索、只保留目标文本的同模型配置,负责回答源通道本身带来多少变化,源标签上限指直接复制源标签得到满分引用与满分槽位的确定性重建对照,负责标定指标天花板与来源路径;前者量增益,后者定边界,搭配后多解决的是把源访问效应与模型规模效应分开,避免把规模差异误读为证据使用能力。
但这张图不能推出三点:不能推出波形质量,不能推出开放场景泛化,不能推出引用格式本身优于等价文本证据。最难的残差情感是 disgust 与 surprised,学习规划器在这些切片上仍比转录文本对照高出 0.439 与 0.496 的引用必需分数,剩余失败集中在 rate 与 stance 槽位失配而非线索遗漏,说明瓶颈已从检索转向 delivery 校准。
去掉源记录与打乱线索时,分数从哪里先崩?
消融要回答的不是哪个模型更大,而是规划器到底用了哪条证据通道。每组对照绑定一个失败解释:转录文本对照测词汇先验,打乱线索对照测引用格式与内容,单线索编辑测局部跟随,ASR 与噪声扰动测引用是否先于流畅性崩溃,规模与 DPO 对照测参数量与偏好调优是否混淆源效应。
PromptClean 10 个分片共 960 个种子模式输出全部严格模式清洁,零模式、解析或线索校验错误,说明解析器与线索校验路径在后续规划器规模下是稳定的。但该运行只做校准,不做模型排序。左面板均值显示证据接地为 0.1748,打乱线索为 0.1643,文本证据为 0.1798;配对增量为相对打乱线索 +0.0105,95% 区间为 0.0090 到 0.0120,相对文本证据为 -0.0050,区间为 -0.0083 到 -0.0017。
看图路径: 1. 先看左面板三种提示模式均值 0.1643、0.1748、0.1798;2. 再看右面板 EG 减 shuffled cue 正向增量约 +0.0105;3. 最后核对 EG 减 text evidence 负向增量约 -0.0050
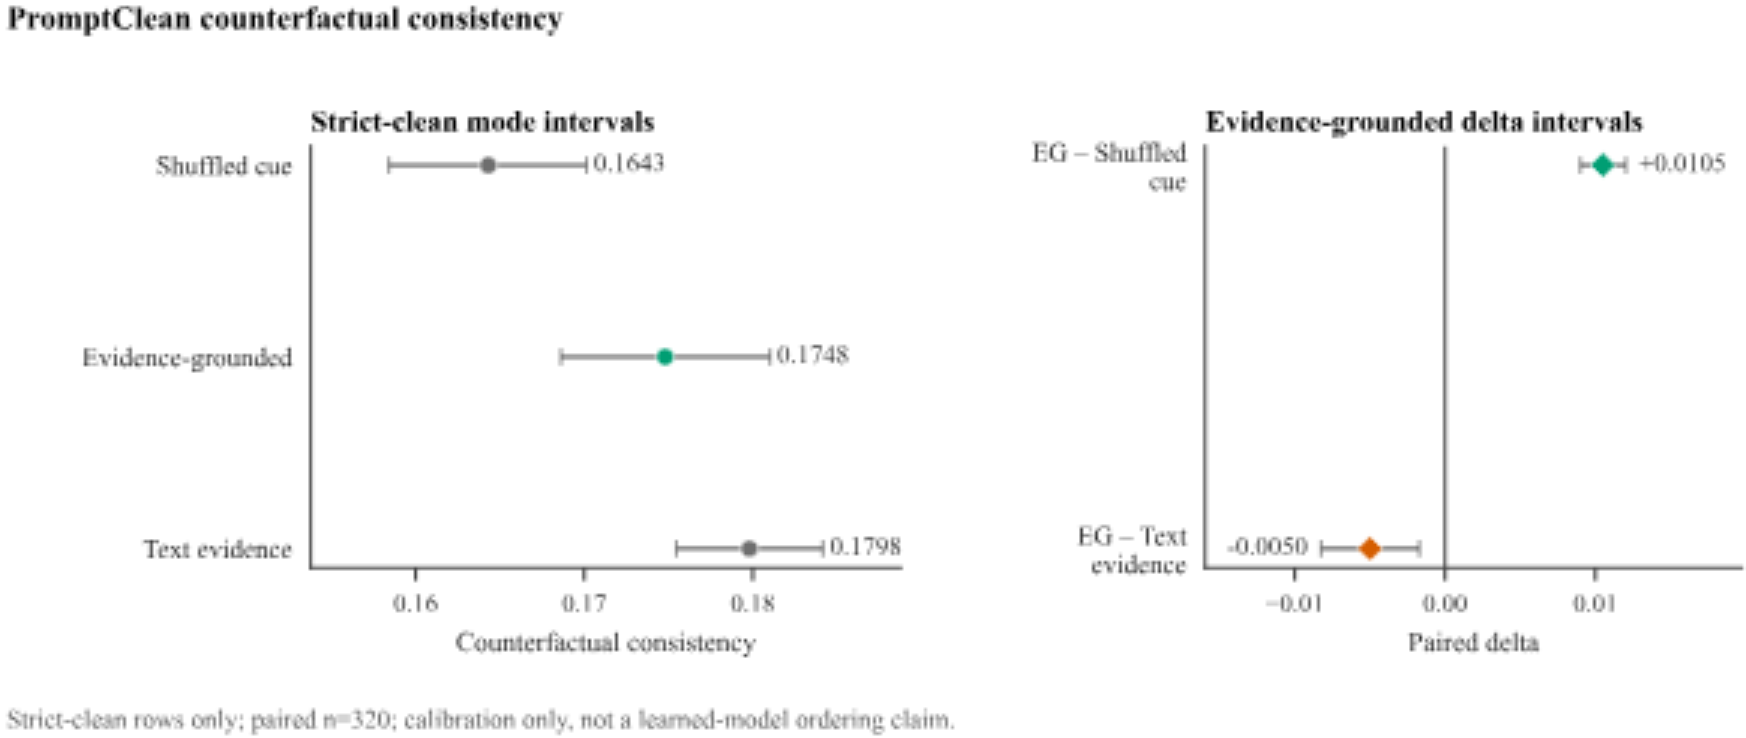
论文图 4。原论文 Figure 4::“PromptClean counterfactual consistency.”。
该模式支持对线索格式敏感,但不支持记录级引用优于等价散文证据的断言,因此原文把该表与图标为校准结果。教学上可以把打乱线索理解为只保留格式与数量、但把别家用例的线索贴过来:如果分数主要靠格式,增益应很弱;实际存在约 0.01 的配对提升,说明内容被使用了,但文本证据仍略高意味着格式之争尚未定论。类比不覆盖的部分是提示灵敏度不等于学习到的引用能力。
为什么槽位准确率高仍可能是捷径,局部性修复改变了什么?
该小节的比较问题是:在看不到的源键与源情感下,学习到的规划器是否仍使用被引记录。统一条件是零源键重叠的 60 训练、16 开发、24 测试划分,以及整情感留出的 angry、calm 与 fearful 设置,基线包括确定性查找、情感先验与常数中性对照,指标方向仍以引用必需分数为首、反事实一致性为局部性判据。
确定性查找在见过键上达到 1.000 精确计划与槽位准确率,移除同键训练后跌到 0.000 精确与 0.242 槽位;情感先验在原始划分上仍达 0.953 槽位准确率,在源键不交叠划分上仍达 0.958,却没有引用强度或身份通道。仅看槽位准确率会把先验误判为接近可用,这正是论文坚持引用与局部性门禁的原因。
源键不交叠划分 × 情感先验: 源键不交叠划分指训练与测试使用互不重叠的 emotion-intensity 键,负责堵住按键查表复用金计划的捷径,情感先验指只看情感词预测槽位而不提供引用通道的规则对照,负责标定不使用源记录也能拿到的分数;前者制造必须泛化的条件,后者标定虚高基线,搭配后才能判断增益是否来自引用记录而非背住映射。
下表是源键不交叠失效切片要回答的定位问题:在相同源键留出条件下,哪些源记录条件仍需局部性修复。统一按计划准确率排序,指标方向是计划准确率与引用必需分数越高越好,瓶颈列区分引用覆盖与槽位翻译失败。
| Source key | Candidate | Cases | Plan acc. | Citation req. | Plan gap | Bottleneck |
|---|---|---|---|---|---|---|
| fearful:normal | Qwen2.5-3B (JSON repair) | 256 | 0.251 | 0.663 | 0.595 | plan slots |
| fearful:normal | Qwen2.5-7B | 256 | 0.269 | 0.671 | 0.645 | plan slots |
| happy:strong | Qwen2.5-3B (JSON repair) | 256 | 0.540 | 0.793 | 0.306 | watch |
| fearful:normal | Qwen2.5-7B | 256 | 0.797 | 0.909 | 0.203 | watch |
| angry:strong | Qwen2.5-3B (JSON repair) | 256 | 0.846 | 0.931 | 0.000 | watch |
| happy:strong | Qwen2.5-7B | 256 | 0.868 | 0.941 | 0.046 | watch |
表中 fearful:normal 在 3B 与 7B 上计划准确率仅 0.251 与 0.269,但引用必需分数仍有 0.663 与 0.671,瓶颈明确标为计划槽位而非引用覆盖;happy:strong 与 angry:strong 的高分行则标为观察项。这种分离说明弱配置保留了引用,但没能把引用翻译成正确的 delivery 取值。表后解释修复的净收益时要保留最公平的基线。7B 局部性 SFT 加反事实修复相对 7B 源键基线提升计划准确率约 0.236、反事实一致性约 0.859、引用必需分数约 0.106、最弱键引用必需分数约 0.238。
相对情感先验则在计划准确率上略低约 0.039,但在反事实一致性上提高 1.000。未胜出项恰是该负向计划增量,它提醒读者先验靠猜情感词仍能命中不少槽位,修复的价值不在猜中更多,而在引用合法且编辑后只动应动槽位。这张表不能推出宽泛的模型排名,结论应限定为受控源标签留出集内的源记录问责。
当前结论停在哪里,哪些泛化不能主张?
构造有效性上,直接测量的是类型化 delivery 字段与编辑线索效应,因为 1440/1440 金计划模式有效且编辑覆盖 8 个槽位;明确缺席的是波形接地与上下文音频评估,因为 0/1440 包含上下文音频;词汇与上下文宽度仅为 2 种目标文本、24 个角色与 1 个场景标签,因此论文停留在受控源标签诊断,而非宽泛上下文泛化基准。
捷径压力同样被量化:见键查找达 1.000 精确与槽位准确率,去同键后跌到 0.000 精确与 0.242 槽位;情感先验无引用仍达 0.667 精确与 0.958 槽位;15/15 源键确定性映射意味着只要不打破键到计划的捷径,宽泛语音推理结论就不成立。这些不是事后辩解,而是纳入设计的证伪工具。
伦理与范围选择也需说清。语音系统可能从敏感音频线索推断情感、意图或立场,论文通过要求每条 delivery 字段给出源链接来降低风险,并把波形结果与身份断言排除在当前评估之外。没有听众小组是范围选择,因为当前断言是关于引用、类型化字段与局部编辑的谓词,不需要招募受试者;若要回答下游波形问题,需另设端点、治理与预注册方案。
要复现这套无听众评估,先跑哪一步,再核对什么?
可运行状态依证据区分:公开仓库提供派生划分与评估代码,支持复现引用合法性、槽位一致、反事实局部性与配对比较;底层原始音频因许可受限不分发,私有检查点与站点启动日志也不在公开包内。不要把有代码等同于有可下载权重或可运行完整系统。
复现先做确定性重建检查:1440 例的源解析、元数据映射、金说话计划、金证据线索、反事实标签、置信策略、许可字段与分裂覆盖应全部通过;再跑 108 例 bootstrap 校准,确认 324 条金线索与 108 条反事实编辑零验证错误,规则基线约为 0.5722 证据 F1、0.2975 槽位准确率与 0.4914 grounded 分数。若此处对不上,应先核对模式版本与用例编号,而非调模型超参数。
学习比较复现时保持 32 种子、固定用例编号与解码设置,只换源访问或模型规模;要求完整种子用例覆盖与严格 JSON 有效后再算配对区间;权重稳健性需在证据重、计划重与无支持奖励变体下重复,若排序翻转则不应视为稳定结论。常见误解有三:把 PromptClean 校准当作模型排序,把编辑用例高分当作引用规划准确,把跨种子标准差当作最终配对置信区间,原文均已明确否定。复现 0.488 效应时必须使用 32 种子 100 例 full100 对照身份,不能用 1440 重建或 16 例快照图点直接相减。
什么条件下值得借用这套方法,下一步最该补什么验证?
当你的任务同样在合成前决定 delivery,且需要回答哪条记录许可了哪个字段时,这套方法值得借用:先定义带引用的说话计划模式,再实现确定性校验器,最后固定引用必需分数为主要端点。它的直接收益是在文本固定、源标签变化时暴露记忆模板,而不是提升音质本身。
不值得照搬的情形是目标为最终听感或偏好排名,此时仍需独立的波形后端溯源与听众研究;也不应在只有两种文本与单一场景的划分上主张开放域泛化。下一步最该补的是许可清晰的语音证据索引、独立线索与计划标注、裁决前一致性,以及打破确定性键映射的更丰富源不交叠划分。
回到中心矛盾:好听不等于有据。在 32 种子 100 例 full100 对照内,源访问的效应大于参数量效应,而槽位准确率虚高与局部性缺失正是需要先修的漏洞。只有当 delivery 选择能说清出处,波形评估才有可信的评判对象。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses